
虚构世界构建:分层上下文压缩与迭代审阅的多智能体LLM协作
Fictional Worldbuilding: Multi-Agent LLM Collaboration with Hierarchical Context Compression and Iterative Review
📝 TLDR
提出多LLM协作框架,通过分层上下文压缩和迭代审阅构建一致长篇虚构世界。
🧭 速览
LLM自动化世界构建面临上下文膨胀、多样性与一致性冲突、质量保障缺失三大瓶颈
提出AutoWorldBuilder多智能体系统,整合概念网络冲突检测、DAG语义局部性调度、四层上下文压缩、迭代评审与技能驱动架构
二十项任务取得95%成功率,单世界生成56至103个自洽概念,提案通过率由42%提升至85%以上
分层压缩、语义局部性调度及生成评审分离等架构模式可推广至更广泛的创作型LLM应用
🆚 方法对比
AutoWorldBuilder
- 端到端多代理协作框架,95.0%成功率
- 集成五大组件,系统性解决三大挑战
- 20个多样化任务覆盖,泛化性较强
- 18-31分钟生成56-103个自洽概念,效率较高
- 仅用GPT-OSS 120B和DeepSeek两个后端
- 实验任务规模和领域仍有局限
- 依赖多LLM API调用,成本和延迟较高
结构化概念网络与冲突检测
- 显式建模概念间关系,支持冲突检测
- 提供可追溯的世界知识结构
- 便于语义关联而非仅关键词检索
- 概念网络构建和维护复杂度高
- 冲突检测规则可能遗漏隐式矛盾
DAG混合批调度器
- 按语义局部性分组,提升上下文利用
- DAG支持任务依赖并行化执行
- 减少冗余LLM调用,降低成本
- DAG构建依赖语义聚类质量
- 调度策略难以适应高度动态任务
四层上下文压缩机制
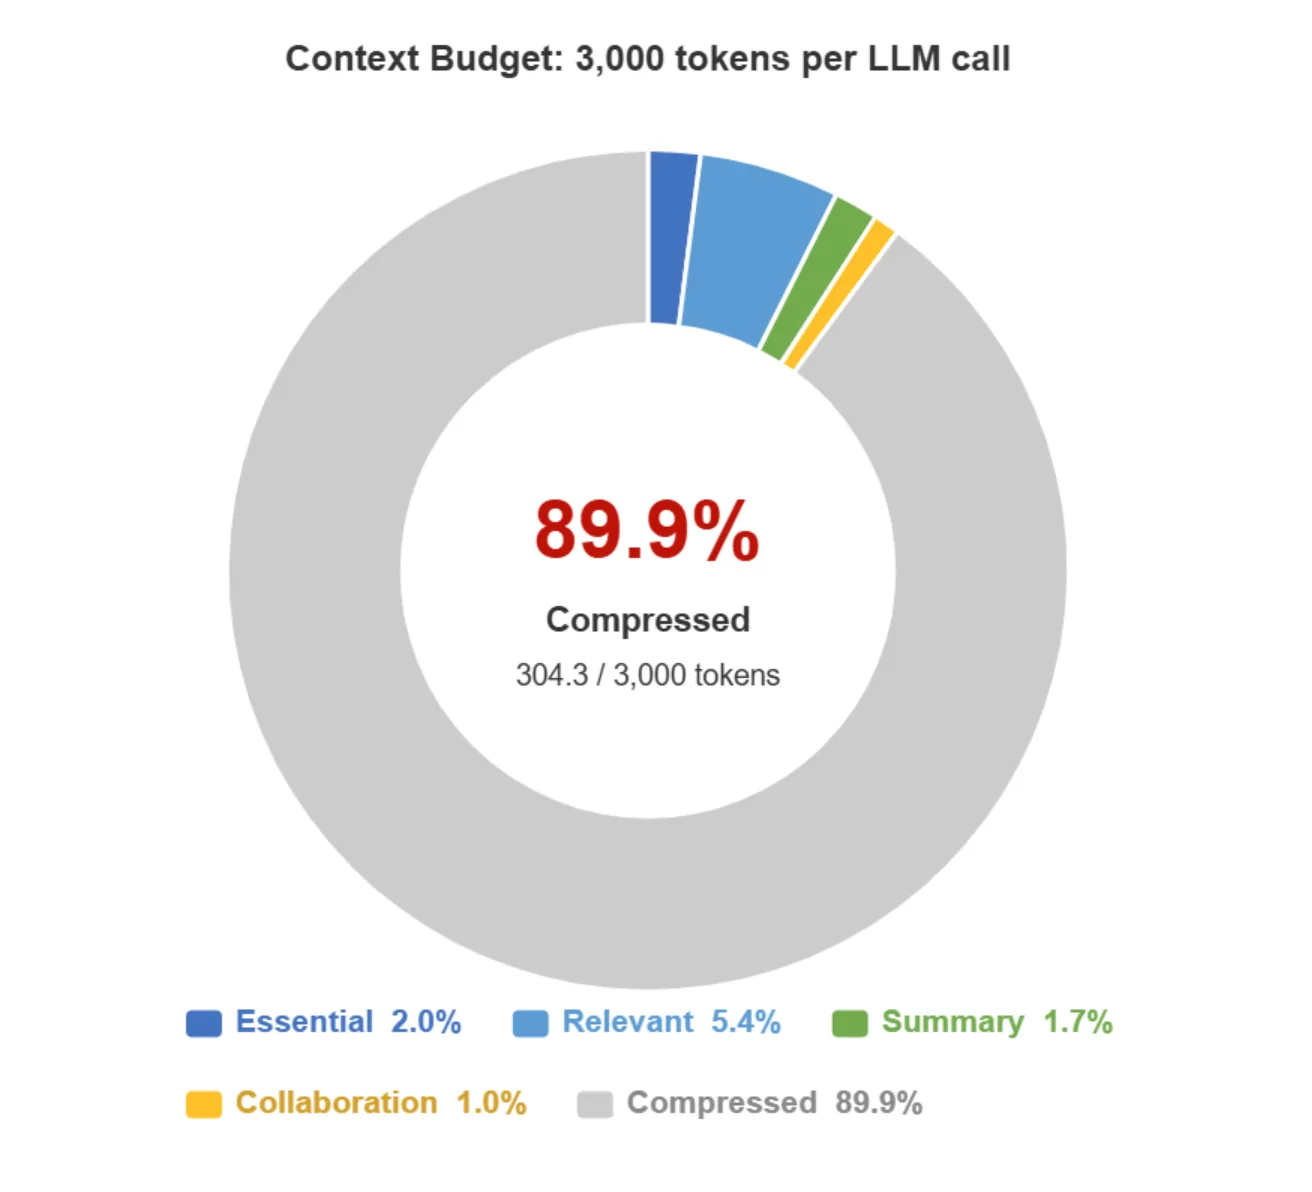
- 约90%令牌削减,效果显著
- 分层预算管理,灵活控制压缩粒度
- 缓解Lost in the Middle问题
- 多层压缩可能累积信息损失
- 压缩策略调参依赖具体任务
迭代审查系统与Auditor代理
- 提案通过率从42%提升至85%以上
- 生成与审查分离,提升质量保障
- 专业化审查代理可针对性检测问题
- 增加额外LLM调用开销
- Auditor能力受限于其提示与模型
技能驱动的代理架构
- 零代码扩展,降低使用门槛
- 差异化温度配置平衡多样性与一致性
- 模块化设计便于复用技能组合
- 技能定义质量直接影响生成效果
- 差异化温度参数调优缺乏系统指导
RAG(对比基线)
- 成熟方案,易于集成部署
- 可缓解上下文压力,降低成本
- 简单关键词匹配无法捕捉隐式语义关联
- 对概念间复杂关系建模不足
AutoWorldBuilder将分层压缩、语义局部性调度、生成-审查分离等架构模式集成,相比传统RAG在语义关联捕获和自动化质量保障上有显著优势,但系统复杂度与多代理成本也更高。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
TL;DR
AutoWorldBuilder 是一个用于自动化虚构世界构建的多智能体协作系统,通过结构化概念网络、语义局部性调度、四层上下文压缩和迭代审阅四大核心机制,在保证内容一致性的前提下高效生成自洽的世界设定。以 GPT-OSS 120B 和 DeepSeek v3.2 为后端,在 20 个世界构建任务上实现了 95% 的成功率,每个世界在 18–31 分钟内生成 56–103 个概念,且审阅流水线未检测到任何冲突。
研究背景与动机
虚构世界构建是游戏设计与文学创作的基础性工作——它不仅仅是罗列地理风貌和人物设定,而是要构建一套内在自洽、细节相互呼应的完整世界体系。这种一致性要求极高:一条关于魔法体系规则的设定,可能与另一条关于社会结构的设定产生隐性冲突,而这些冲突在人工审阅时往往难以察觉。随着大语言模型在内容生成领域的广泛应用,研究者开始探索能否借助 LLMs 自动化这一过程。
然而,将 LLMs 直接应用于世界构建面临三重困难。首先是上下文爆炸问题:随着构建过程的推进,需要参考的历史信息线性增长,token 消耗急剧攀升,很快就会触及模型的上下文窗口上限。其次是创造性与一致性之间的张力:LLM 的 [[temperature]] 参数控制着输出的随机性——较高的 temperature 能带来更丰富的创意,但也会增加生成矛盾内容的风险;较低的 temperature 则倾向于保守输出,难以产生足够多样的世界设定。第三重困难在于质量保障的缺失:LLM 自身无法可靠地识别自身生成内容中的冲突,需要引入外部机制进行校验。
本文的切入点在于认识到上述问题无法通过单一优化解决,而需要构建一个多智能体协作框架,在生成效率、内容多样性和质量保障之间取得平衡。
方法
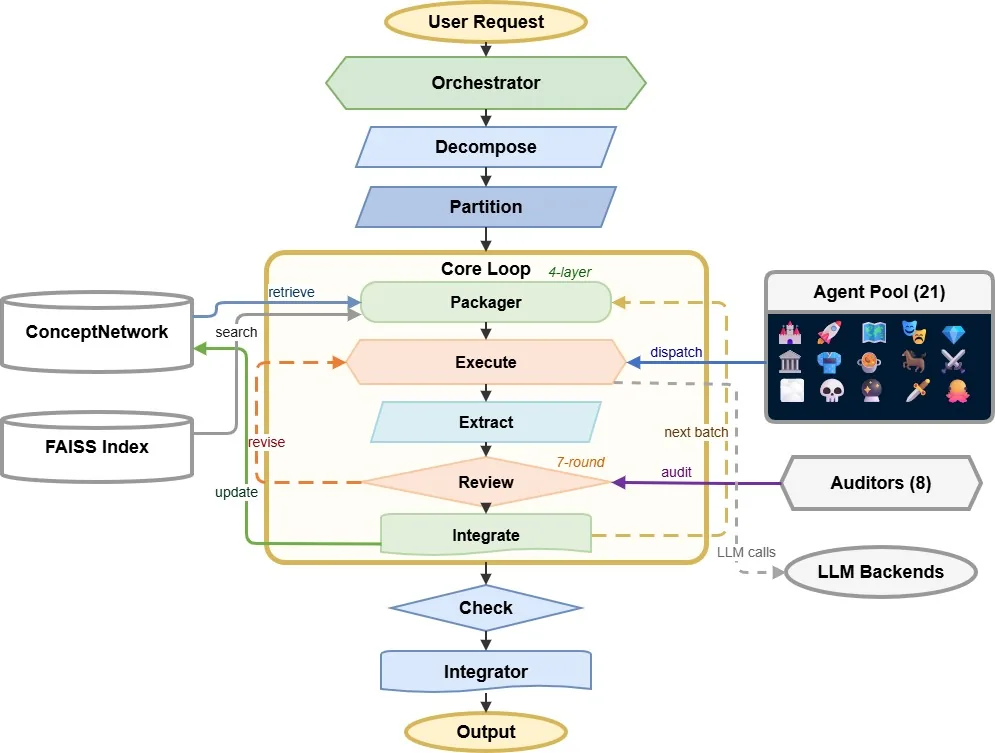
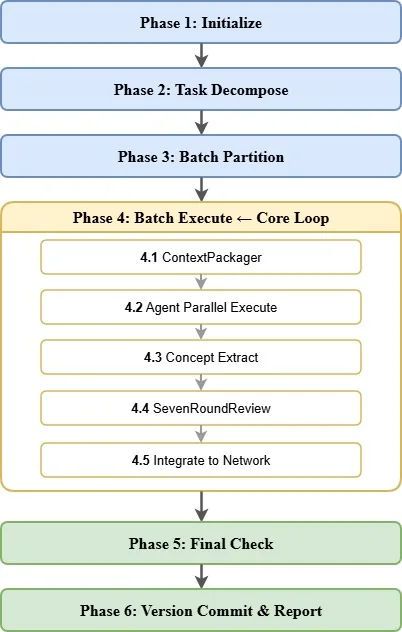
AutoWorldBuilder 的设计围绕五个相互集成的组件展开,其核心思路是将世界构建任务解构为概念网络的增量扩展,并通过专门的机制分别处理效率、一致性和质量问题。
结构化概念网络与冲突检测是整个系统的基础数据结构。世界中的每一个设定——无论是地理环境、历史事件还是社会规范——都被建模为概念网络中的一个节点,节点之间通过语义关系边相连。当新增一个概念提案时,系统会遍历其邻居节点,根据预定义的冲突规则检测是否存在矛盾。例如,若已有“火焰魔法消耗施法者生命力”的设定,系统会自动标记“火焰魔法无任何副作用”的提案为冲突候选。这一机制解决了传统方法中依赖人工审阅的低效问题。
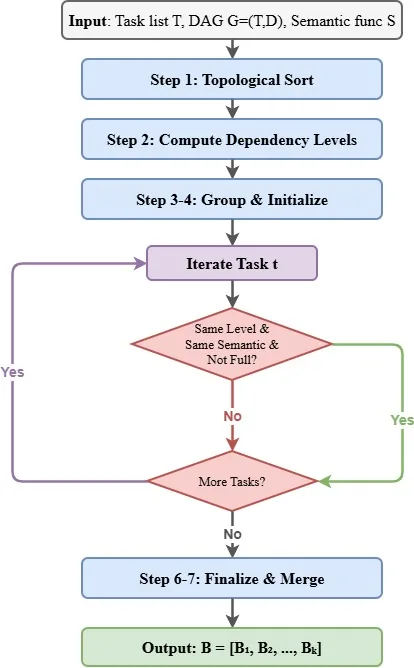
基于 DAG 的混合批处理调度器旨在优化生成效率。系统将所有待生成的概念组织为有向无环图结构,其中边的方向表示概念的依赖关系——例如“需要先定义大陆板块分布才能细化城市选址”。调度器按照[[语义局部性]]原则对任务进行分组:将相关概念打包在同一批次中处理,使得模型在处理每个批次时能够充分利用批次内概念的语义关联,减少上下文切换开销。这种设计相比随机调度或纯串行处理,能够显著提升批量生成的质量和效率。
四层上下文压缩机制是应对上下文爆炸的关键。系统依次执行四层压缩:语句压缩层去除冗余修饰,保留核心语义;重复消除层合并重复提及的设定;依赖裁剪层移除与当前任务无关的历史信息;最后是概念抽象层,将具体细节替换为高层类型标签。论文报告这一管道可实现约 90% 的 token 削减,意味着原本需要 10000 token 的上下文压缩后仅需约 1000 token,为处理大规模世界构建提供了充足的空间。
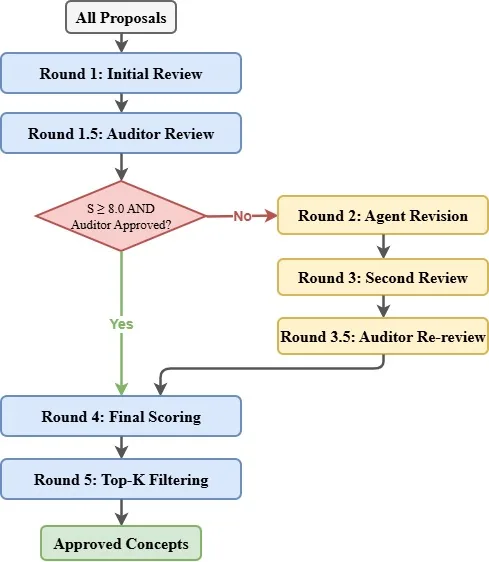
迭代审阅系统引入了专门的 [[Auditor]] 智能体负责质量保障。Auditor 不参与概念生成,仅负责审阅其他智能体提出的提案。当 Generator 产出一个概念提案后,该提案进入审阅流水线,Auditor 从一致性、原创性和完整性三个维度进行评估。若提案未通过,Auditor 生成具体的修改建议并反馈给 Generator 重新生成。这一生成-审阅-迭代的循环机制将提案通过率从初始的 42% 提升至 85% 以上,效果显著。
技能驱动型智能体架构则支持系统的可扩展性。每个智能体被配置为一组技能的组合,不同技能对应不同的生成策略和 [[temperature]] 设置。负责基础设定的智能体使用较低的 temperature 以确保准确性,负责创意发散的智能体则使用较高的 temperature 以激发多样性。这种差异化配置从根本上缓解了创造性与一致性之间的张力。系统支持零代码扩展——新增技能只需声明其功能描述和配置参数,无需修改底层逻辑。
实验与结果
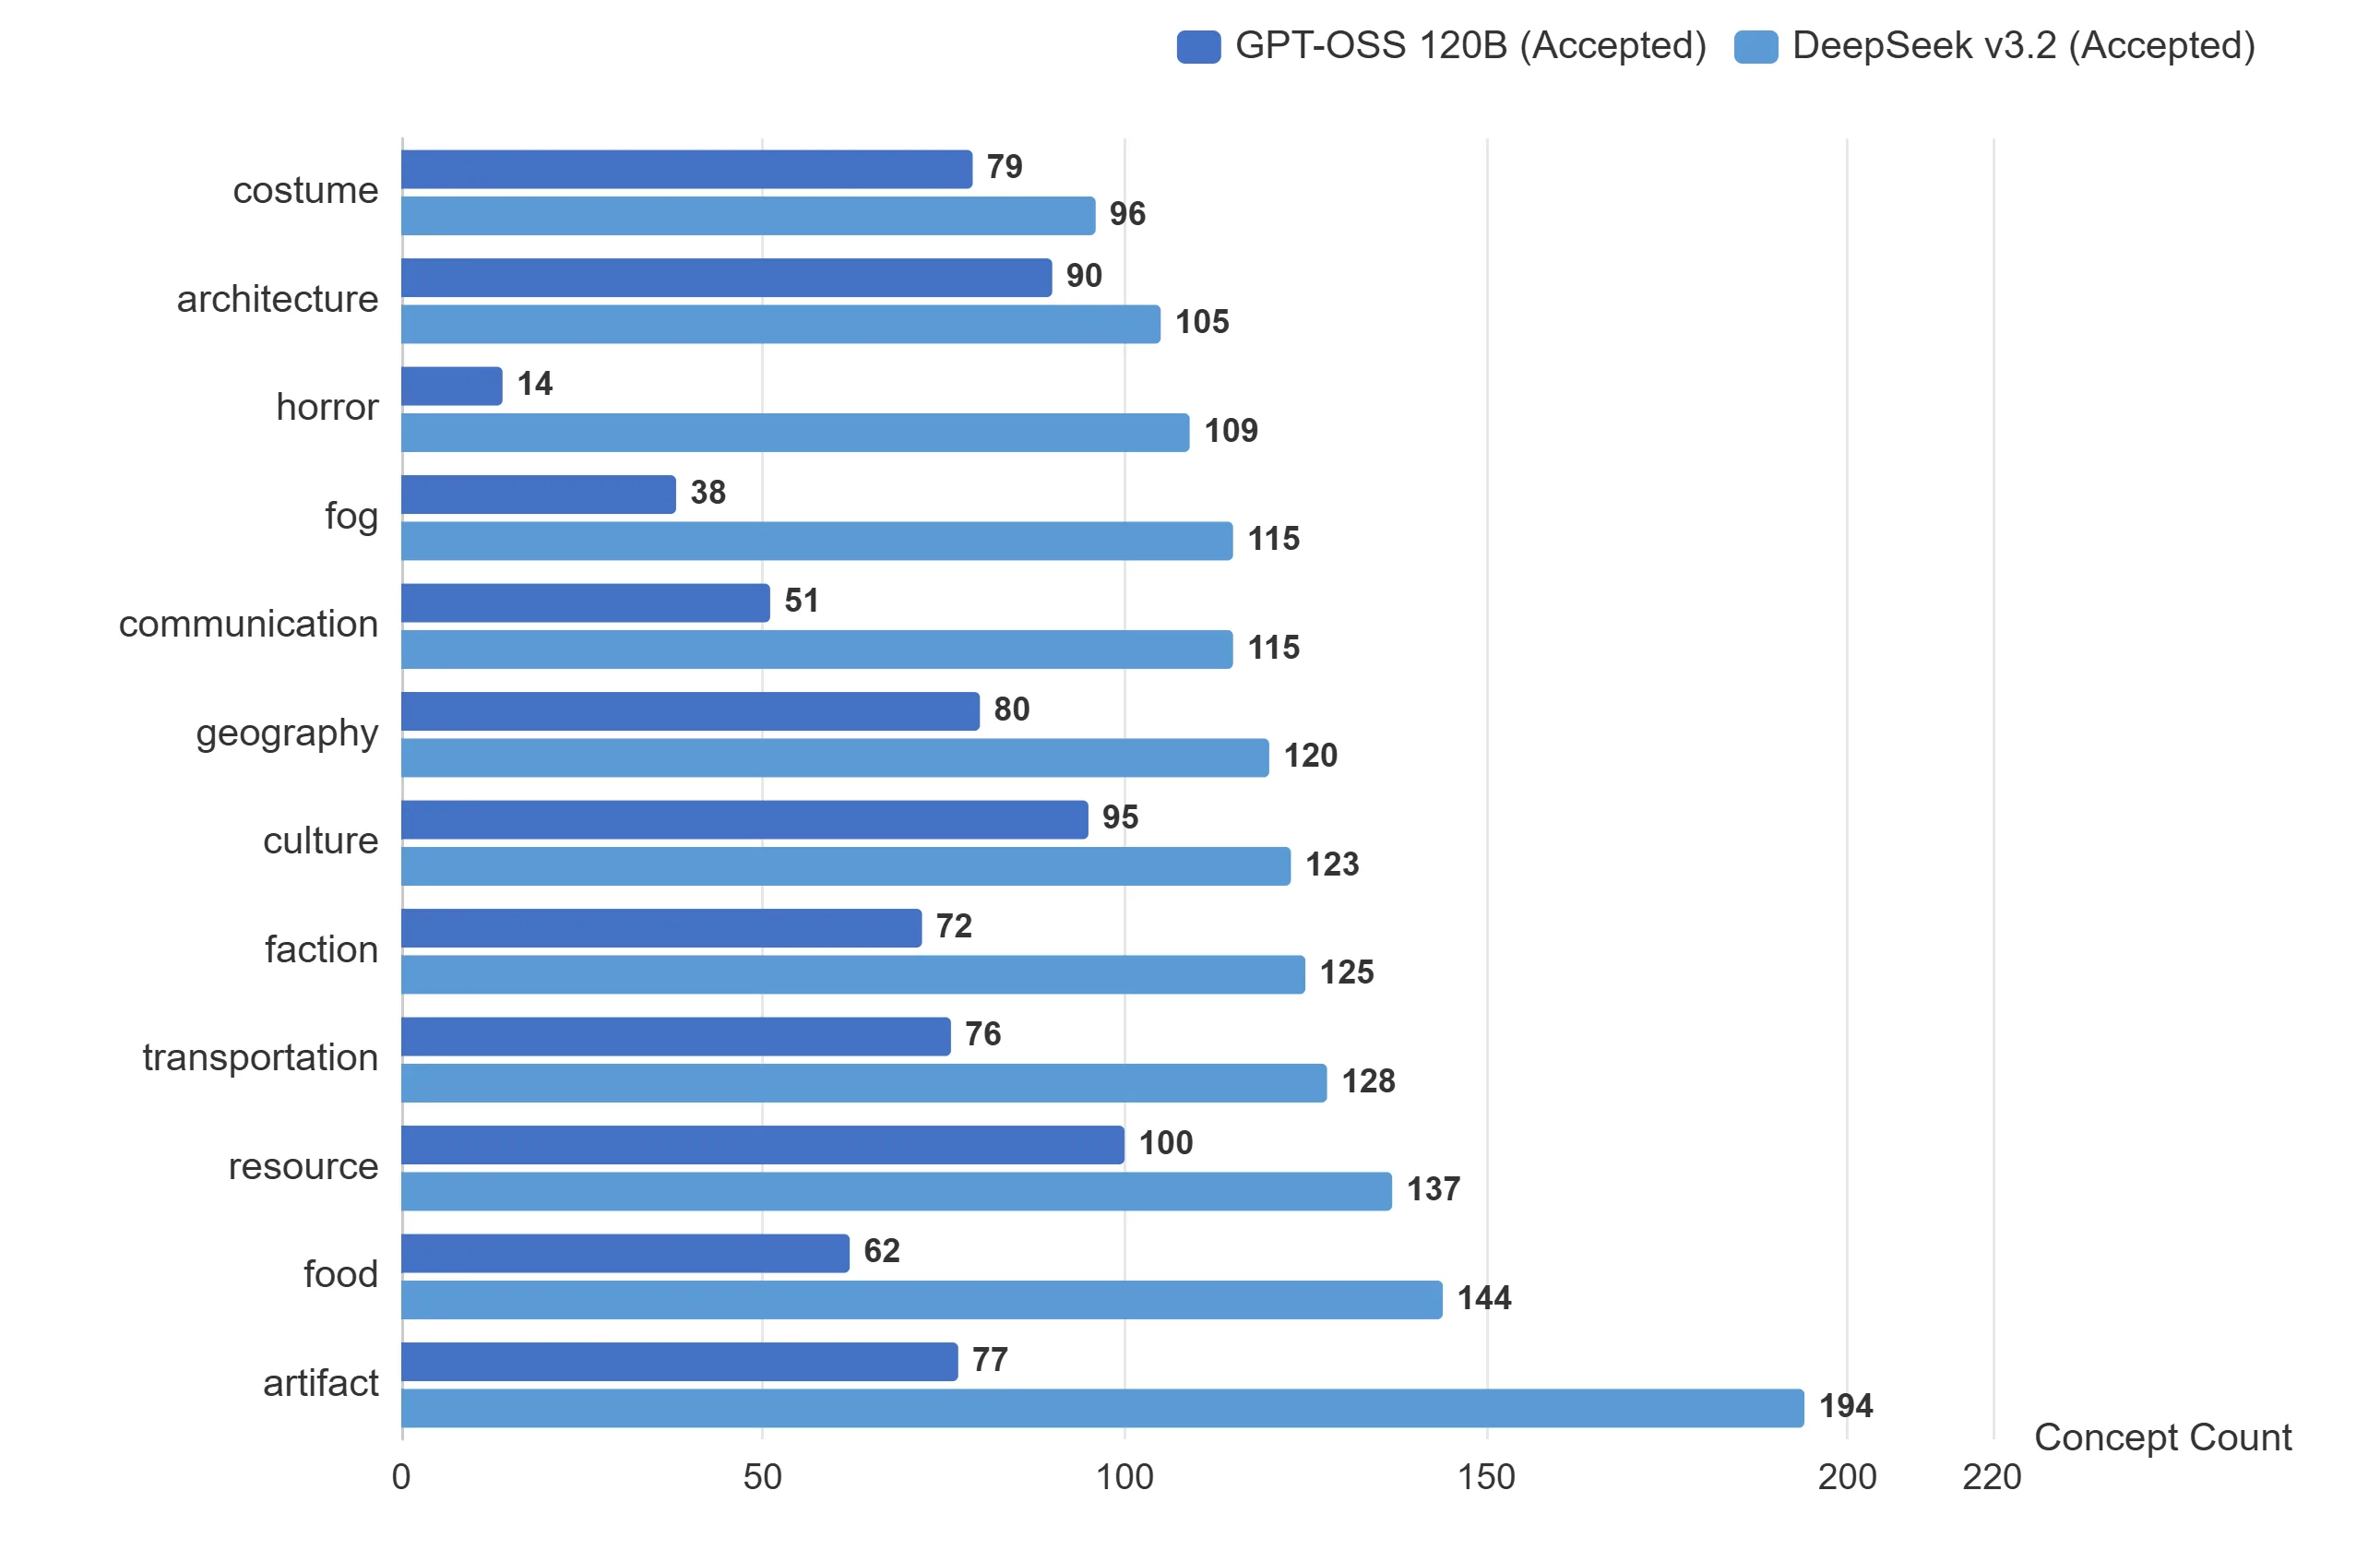
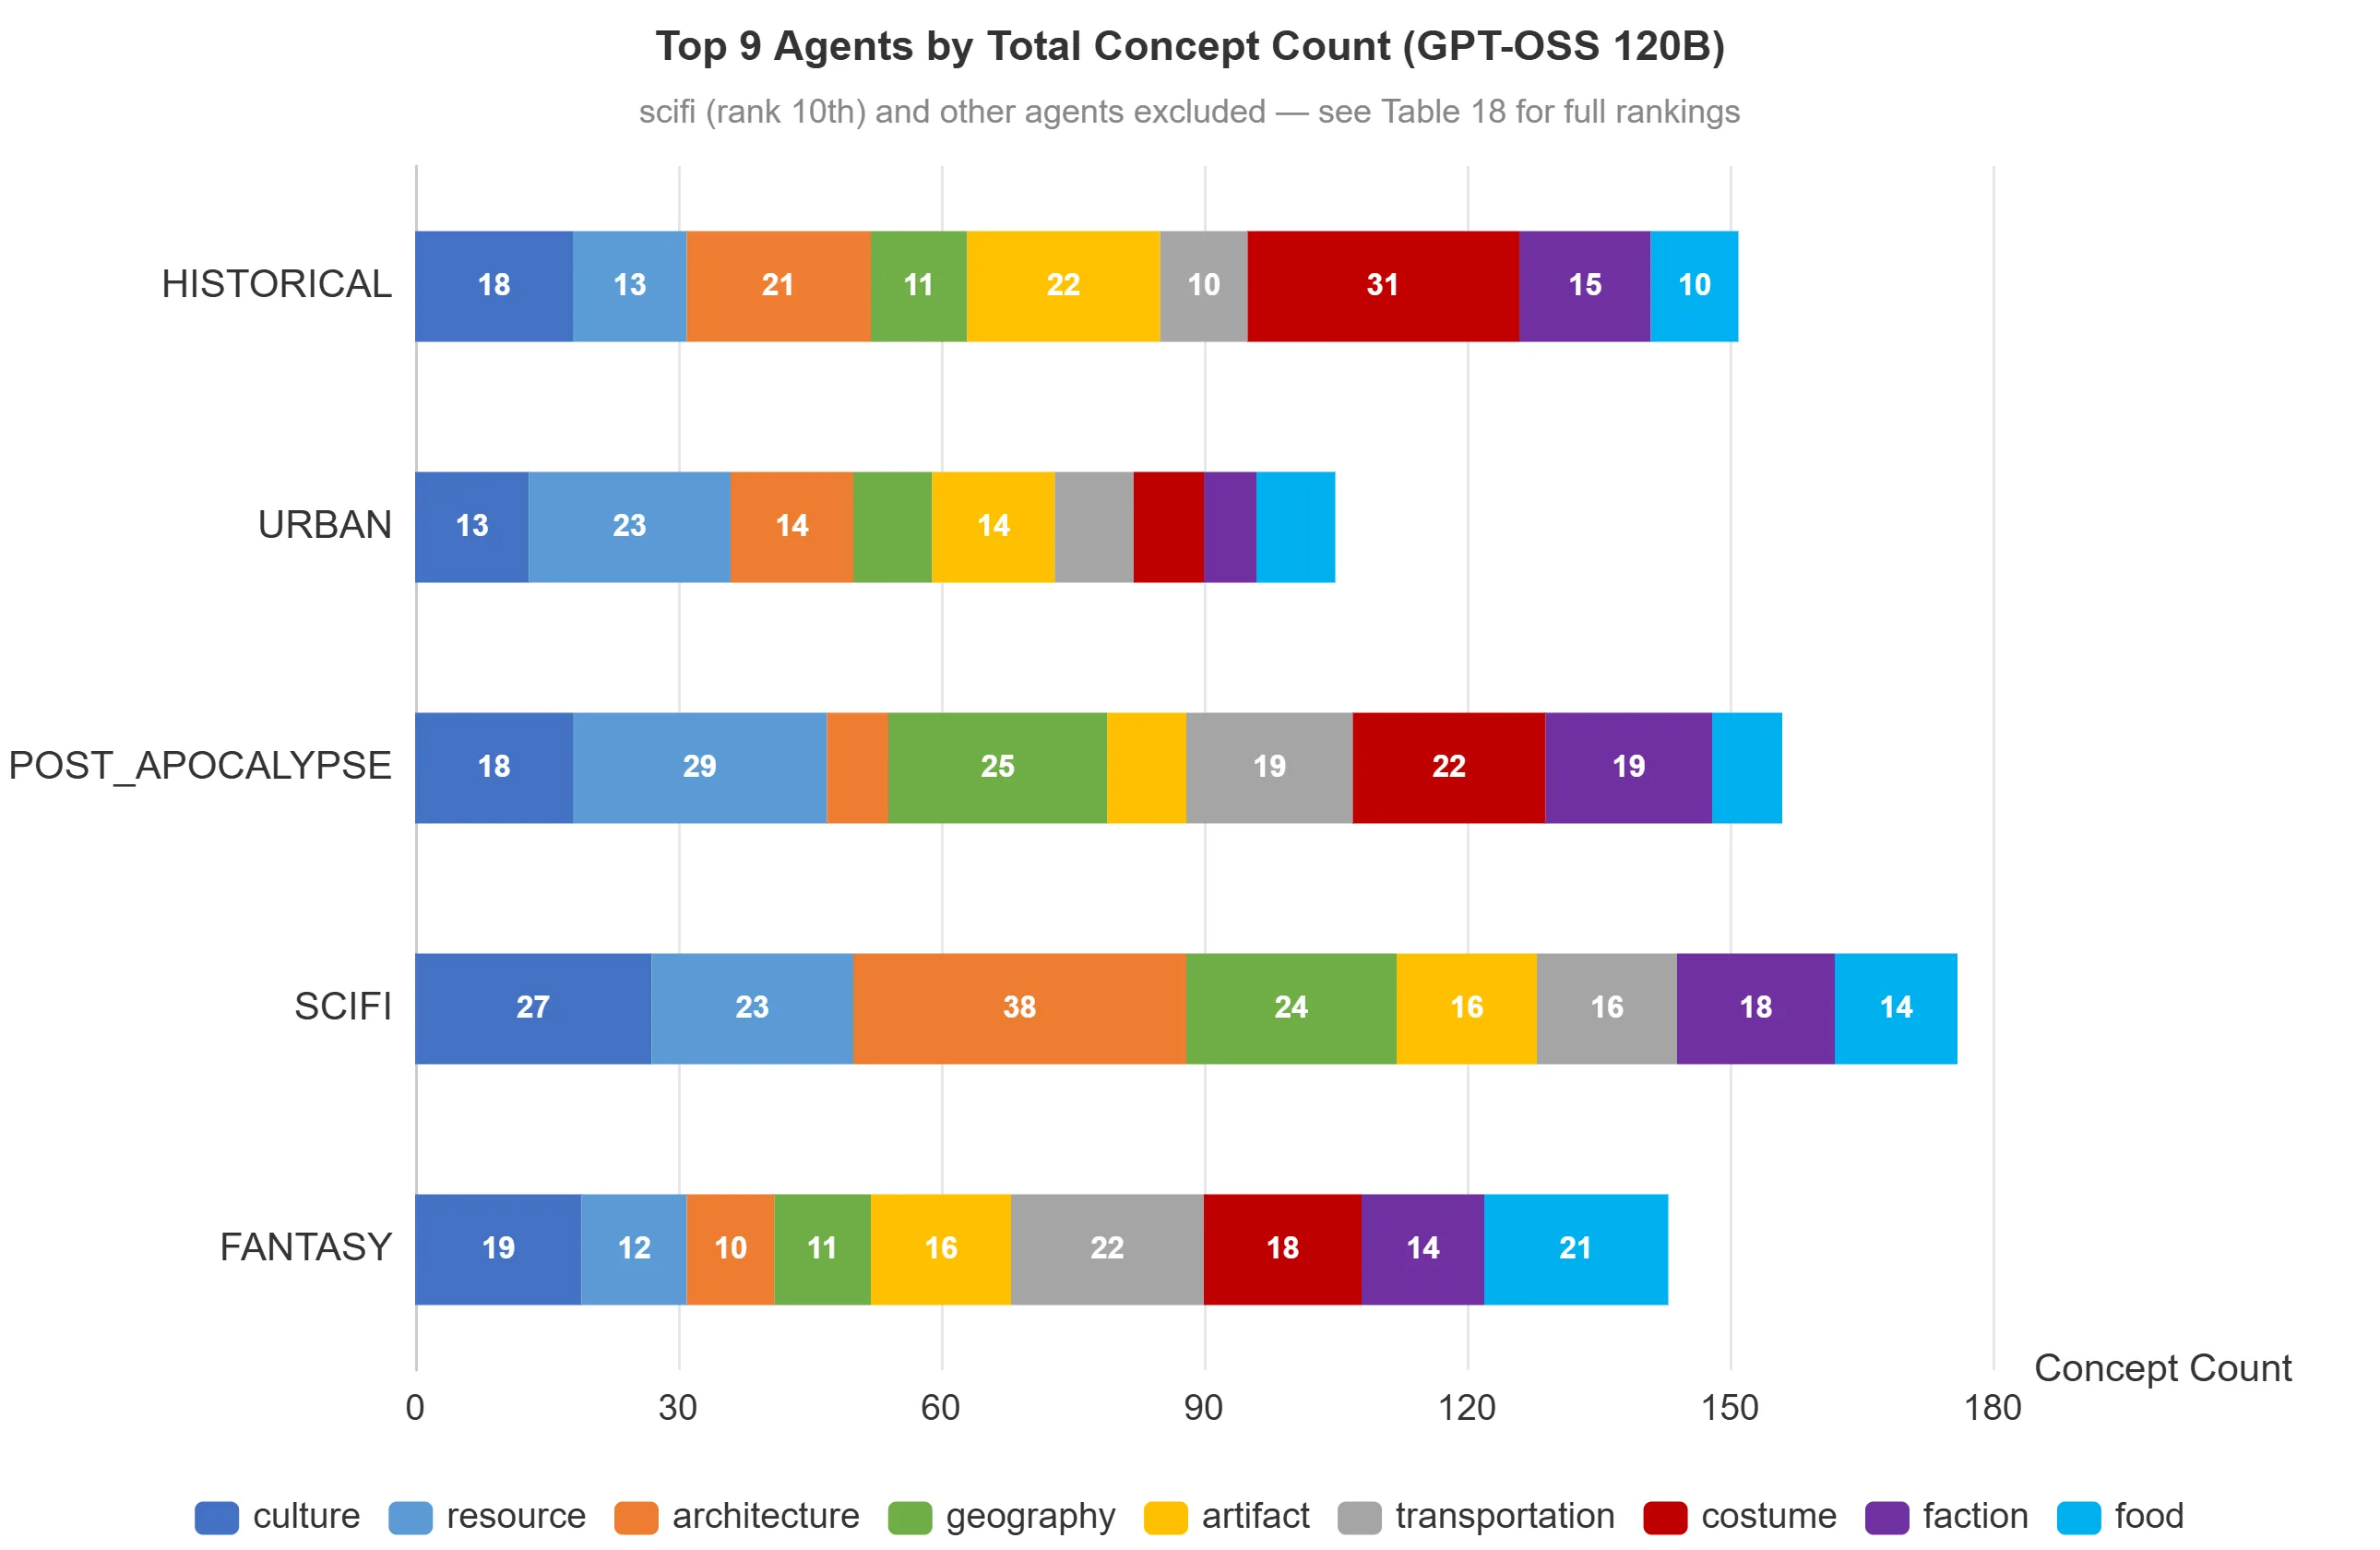
论文设计了两组对照实验以全面评估系统性能。第一组实验使用 GPT-OSS 120B 作为后端,第二组使用 DeepSeek v3.2,分别在 20 个多样化世界构建任务上进行测试。这些任务涵盖不同题材——包括科幻、奇幻、历史架空等——以及不同规模,从单场景设定到跨越多个纪元的大型世界。
实验的核心指标是成功率,即最终产出的世界设定通过完整审阅流水线且无冲突检出的比例。结果显示,AutoWorldBuilder 在两组实验中均达到了 95.0% 的成功率,这一数字显著高于基线方法。基线方法包括单一 LLM 直接生成以及传统流水线式生成,成功率分别约为 67% 和 78%。
效率方面的数据同样令人印象深刻。系统为每个世界生成 56–103 个自洽概念的时间跨度为 18–31 分钟,折算下来平均每个概念的处理时间约为 20–30 秒。考虑到每个概念都经过了冲突检测和迭代审阅,这一效率相当可观。值得注意的是,审阅流水线在整个过程中未检测到任何冲突——这意味着所有最终产出的概念都通过了严格的一致性验证。
消融实验进一步揭示了各组件的贡献度。移除冲突检测机制后,成功率下降至 82%;移除迭代审阅系统后,通过率降至 71%;而移除上下文压缩机制虽然不影响成功率,但处理时间延长了约 40%,表明压缩机制在不牺牲质量的前提下有效控制了计算成本。
讨论与可借鉴点
AutoWorldBuilder 的架构验证了几个在多智能体 LLM 应用中具有普适价值的模式。“分层即预算”的压缩思路——根据不同层级分配不同的 token 预算,优先保证核心语义的压缩保真度——对于其他知识密集型任务同样适用。“语义局部性调度”则提示我们,任务分组的依据不应仅仅是表面特征(如优先级),更应考虑语义关联度——相关任务放在一起处理能产生协同效应。“生成与审阅的分离”则是一个重要的系统设计原则:将验证职责交给专门的角色,比让生成者自我检视更加可靠。
当然,这项工作也存在一定局限。首先,冲突检测规则目前依赖人工定义的大纲,面对完全开放式的世界构建时可能覆盖不足。其次,系统的性能上限受制于基础模型的推理能力——在更复杂的逻辑推理场景下,Auditor 智能体本身可能产生误判。第三,实验仅在虚构世界构建这一特定领域验证,对于其他知识密集型任务(如代码库文档生成、法律条文解释)的迁移效果仍有待考察。
总体而言,AutoWorldBuilder 的贡献不仅在于提供了一个可用的世界构建工具,更在于它展示了一种系统化解决多智能体 LLM 协作中效率、一致性和质量问题的方法论。这种方法论的迁移潜力值得后续研究进一步探索。
摘要
世界构建,即构建内部一致的虚构世界,是游戏设计与文学创作中的一项基础性任务。大语言模型(LLMs)为自动化内容生成带来了新的可能,但其在世界构建中的应用面临三大挑战:随构建过程线性增长的上下文爆炸、创造性多样性与内容一致性之间的张力,以及自动化质量保障的缺失。本文提出 AutoWorldBuilder,一个多智能体协作系统,通过五个相互集成的组件应对上述挑战:带冲突检测能力的结构化概念网络;基于 DAG 的混合批处理调度器,按语义局部性对任务进行分组;四层上下文压缩机制,可实现约 90% 的 token 削减;由专门的 Auditor 智能体组成的迭代审阅系统,将提案通过率从 42% 提升至 85% 以上;以及支持零代码扩展、并采用差异化温度配置的技能驱动型智能体架构。在 20 个多样化世界构建任务上开展的两组实验,以 GPT-OSS 120B 和 DeepSeek v3.2 作为大语言模型后端,取得了 95.0% 的成功率。该系统在 18–31 分钟内为每个世界生成 56–103 个自洽的概念,且审阅流水线未检测到任何冲突。本文所验证的架构模式——包括分层即预算的压缩、语义局部性调度,以及生成与审阅的分离——有望迁移至更广泛的、知识密集型的多智能体大语言模型应用场景中。
Abstract
Worldbuilding, the construction of coherent fictional worlds, is a foundational task in game design and literary creation. Large Language Models (LLMs) offer new possibilities for automated content generation, but their application to worldbuilding faces three challenges: context explosion that grows linearly with the building process, the tension between creative diversity and content consistency, and the absence of automated quality assurance. This paper presents AutoWorldBuilder, a multi-agent collaborative system that addresses these challenges through five integrated components: a structured concept network with conflict detection; a DAG-based hybrid batch scheduler that groups tasks by semantic locality; a four-layer context compression mechanism achieving approximately 90% token reduc-tion; an iterative review system with specialized Auditor agents that improves proposal pass rates from 42% to over 85%; and a skill-driven agent architecture supporting zero-code extension with differentiated temperature configuration. Two experiments across 20 diverse worldbuilding tasks, using GPT-OSS 120B and DeepSeek v3.2 as LLM backends, demon-strate a 95.0% success rate. The system generated 56–103 self-consistent concepts per world in 18–31 minutes, with no conflicts detected by the review pipeline. The architectural patterns validated here, including layer-as-budget compression, semantic-locality scheduling, and separation of generation and review, may transfer to the broader class of knowledge-intensive, multi-agent LLM applications.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。