
📝 TLDR
LLM智能体在长程交互任务中决策能力强,但难以有效利用失败轨迹:全量重试代价高,经验检索会稀释关键信号。为此提出PivoARL框架,通过结构化反思定位关键错误回合,从该状态局部重试以复用正确前缀。在4个智能体任务和7个搜索问答基准上,PivoARL相比MetaRL平均提升约11.5%,在Minesweeper上相比GiGPO提升超45%,并减少约42%的交互轮次。
🧭 速览
LLM智能体未能有效利用失败经验,全量重试交互成本高,状态无关的经验检索则会稀释关键信号。
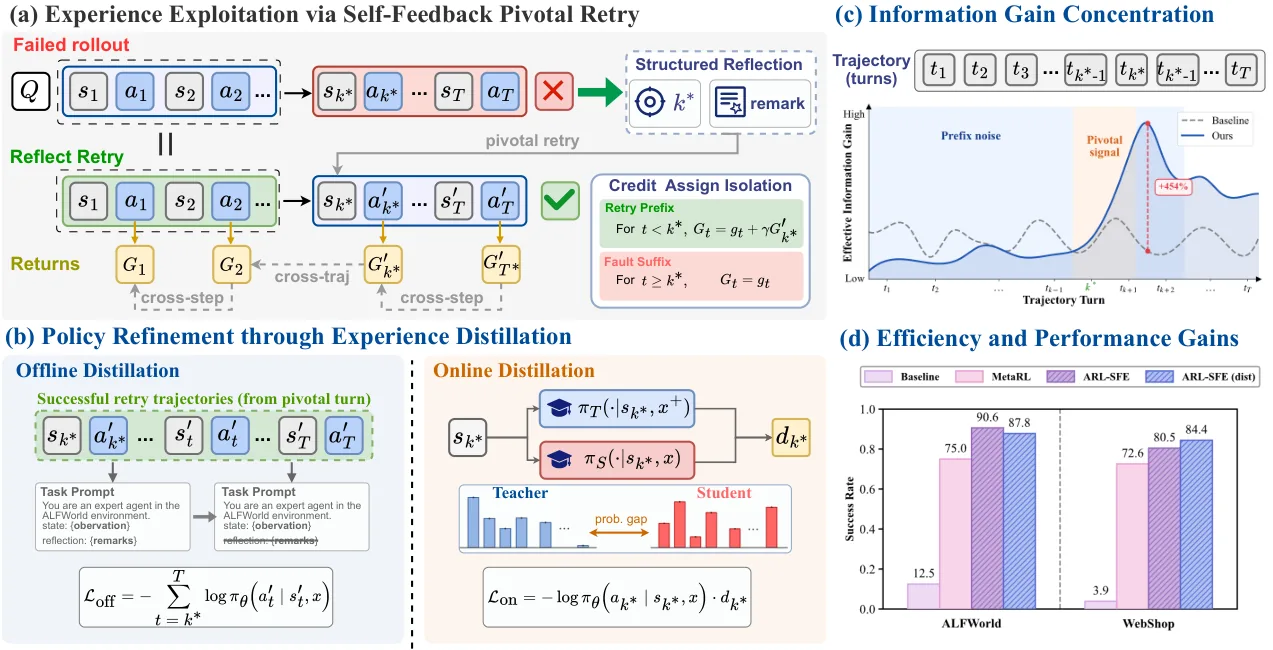
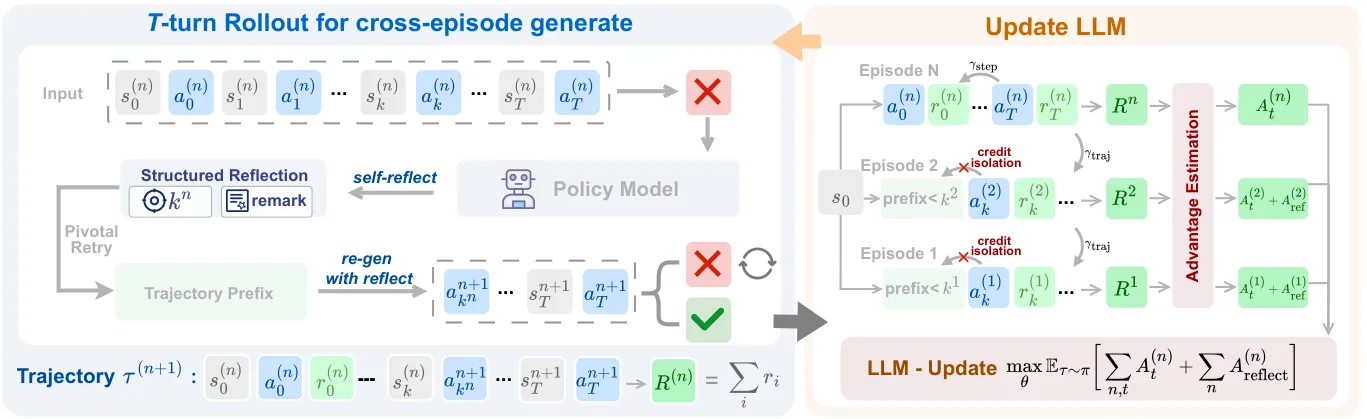
通过结构化反思定位关键错误回合,从关键状态局部重试复用正确前缀,并设计关键感知信用分配机制与隐式反思回报。
在4个智能体任务与7个搜索问答基准上Pass@2/3平均较MetaRL提升约11.5%,Minesweeper上较GiGPO提升超45%,交互轮次减少约42%。
关键回合重试将有用经验信号集中于错误边界附近,缓解信号稀释,为LLM智能体高效经验利用提供新范式。
🆚 方法对比
PivoARL
- 通过关键步骤局部重试减少约42%-44%交互成本
- Pass@1在超80%任务上提升,信息增益理论支撑
- 关键感知信用分配隔离错误后缀,奖励正确前缀
- 相比GiGPO在Pass@1/2/3分别提升约10.3%/15.3%/14.7%
- 依赖结构化自反思质量,反思错误会传播
- 关键步识别可能受早期错误累积影响
- 在超长轨迹中定位关键步仍具挑战
- 隐式反思回报的优化目标设计较复杂
Full-retry方法
- 实现简单,无需定位关键步
- 可彻底重新探索新策略避免路径锁定
- 适用于错误根源不确定的场景
- 交互成本高,每次重试需重新执行全部步骤
- 有效信号被长轨迹稀释(信息增益低)
- 正确前缀未被复用造成大量冗余交互
Experience Retrieval
- 可从大规模历史经验中检索有用信号
- 利用跨回合经验提升泛化能力
- 避免完全重试的高成本
- 状态无关检索易稀释关键经验信号
- 易受大规模经验干扰导致学习不稳定
- 检索到的经验可能与当前状态不匹配
SkillsRL
- 静态技能库可复用成熟经验
- 提供稳定可复用的技能表示
- 静态库难以适应任务动态演化
- 技能粒度固定,灵活性受限
- 对长视野任务适应性不足
MetaRL
- 元学习框架可跨任务迁移经验
- 适用于多样化代理任务场景
- 平均性能低于PivoARL约11.5%
- 经验利用效率有待提升
- 在长视野任务中信用分配仍面临挑战
GiGPO
- 组内策略优化方法,适用于代理任务
- 提供基线级别的信用分配机制
- 在Minesweeper环境上低于PivoARL超45%
- 未利用关键步局部重试机制
- 信号利用效率不如PivoARL
GRPO
- 组相对策略优化,搜索类QA任务有效
- 实现相对简单,训练稳定
- 在搜索QA任务上低于PivoARL约20.5%
- 未针对长视野代理任务优化
- 缺乏关键步感知机制
PivoARL通过关键步感知局部重试与信用分配,在交互效率和Pass@k上全面优于Full-retry、Experience Retrieval等基线方法,在代理任务上优于GiGPO/MetaRL,在搜索QA任务上优于GRPO。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 19 张)
展开查看 19 张图
TL;DR
这篇论文针对大语言模型智能体在长程交互任务中难以高效利用失败轨迹的问题,提出了 PivoARL 框架。该框架通过结构化反思定位关键错误回合,仅从该状态进行局部重试,从而复用正确轨迹前缀并避免经验稀释。在 4 个智能体任务和 7 个搜索问答基准上的实验表明,PivoARL 相比 MetaRL 平均提升约 11.5%,在扫雷环境中相比 GiGPO 提升超 45%,同时减少约 42% 的交互轮次。
研究背景与动机
大语言模型在复杂交互任务中已经展现出相当强的决策能力,从多轮对话系统到游戏环境中的策略规划,LLM 智能体正被广泛应用于各类长程决策场景。然而,一个核心问题始终困扰着这一领域:当智能体的某次尝试失败时,如何高效地从中学习并改进?
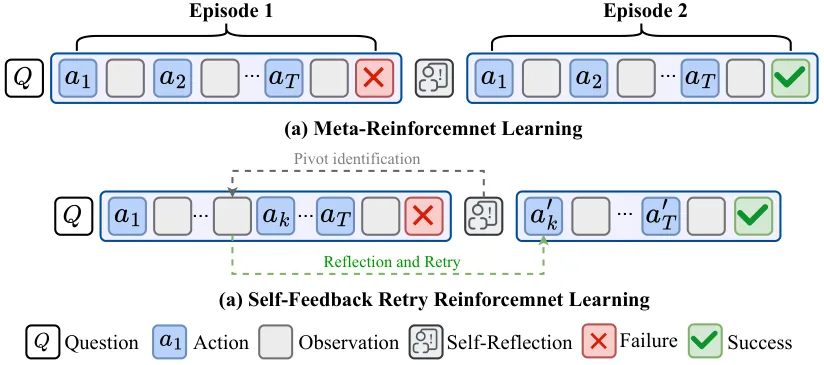
论文首先分析了现有方法的两难困境。完全重试(full retry)要求从头开始整个任务序列,这种方式虽然能保证探索的完整性,但会造成高昂的交互成本——尤其是在需要多轮环境交互的任务中,每次重试都要消耗大量计算和通信资源。另一种思路是通过经验检索来复用历史轨迹,但论文指出这种方法存在信号稀释问题:从大量历史经验中检索相关内容时,真正关键的经验信号会被无关信息冲淡,导致智能体难以聚焦于真正需要改进的环节。
这两种方法的核心矛盾在于,完全重试追求的是探索的充分性但代价高昂,而经验检索追求的是效率但可能丢失关键信息。论文的切入点是:能否只针对那些真正出错的环节进行定向重试,而保留此前正确的执行路径?这个思路既避免了全量重试的冗余开销,又比粗粒度的经验检索更加精准。
方法
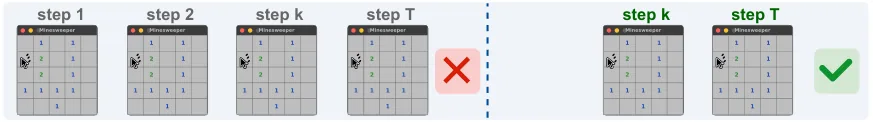
PivoARL 的核心设计围绕一个关键洞察展开:失败轨迹中,真正需要关注的是从某个关键状态开始走向错误方向的那一步。如果能准确定位这个关键转折点,就可以在该点之后进行局部重试,同时保留此前的正确执行。
论文将这个关键转折点称为「关键错误回合」(pivotal erroneous turn),其形式化定义为:智能体在该回合的决策导致了后续轨迹的失败,而此前的决策序列是正确的。基于这一概念,PivoARL 的执行流程分为三个阶段。
第一阶段是结构化反思。给定一条失败轨迹,智能体需要分析整个执行序列,识别出从哪一步开始事情出了问题。论文设计了一套结构化的反思模板,引导智能体不仅判断成功或失败,还要追溯失败的根源。这与直接要求智能体「反思为什么失败了」的直觉做法不同,结构化反思强制智能体沿着时间线逐回合分析,从而更有可能准确定位到真正的关键转折点。
第二阶段是局部重试。确定关键回合后,PivoARL 仅从该状态开始重新生成后续动作,而保留关键回合之前的全部决策序列作为正确前缀。这里的关键设计在于,重试的起始点是被识别为「出错」的那个状态,而非从头开始。这意味着即使多次重试失败,智能体也无需重复那些已经正确的部分,极大地提高了经验利用的效率。
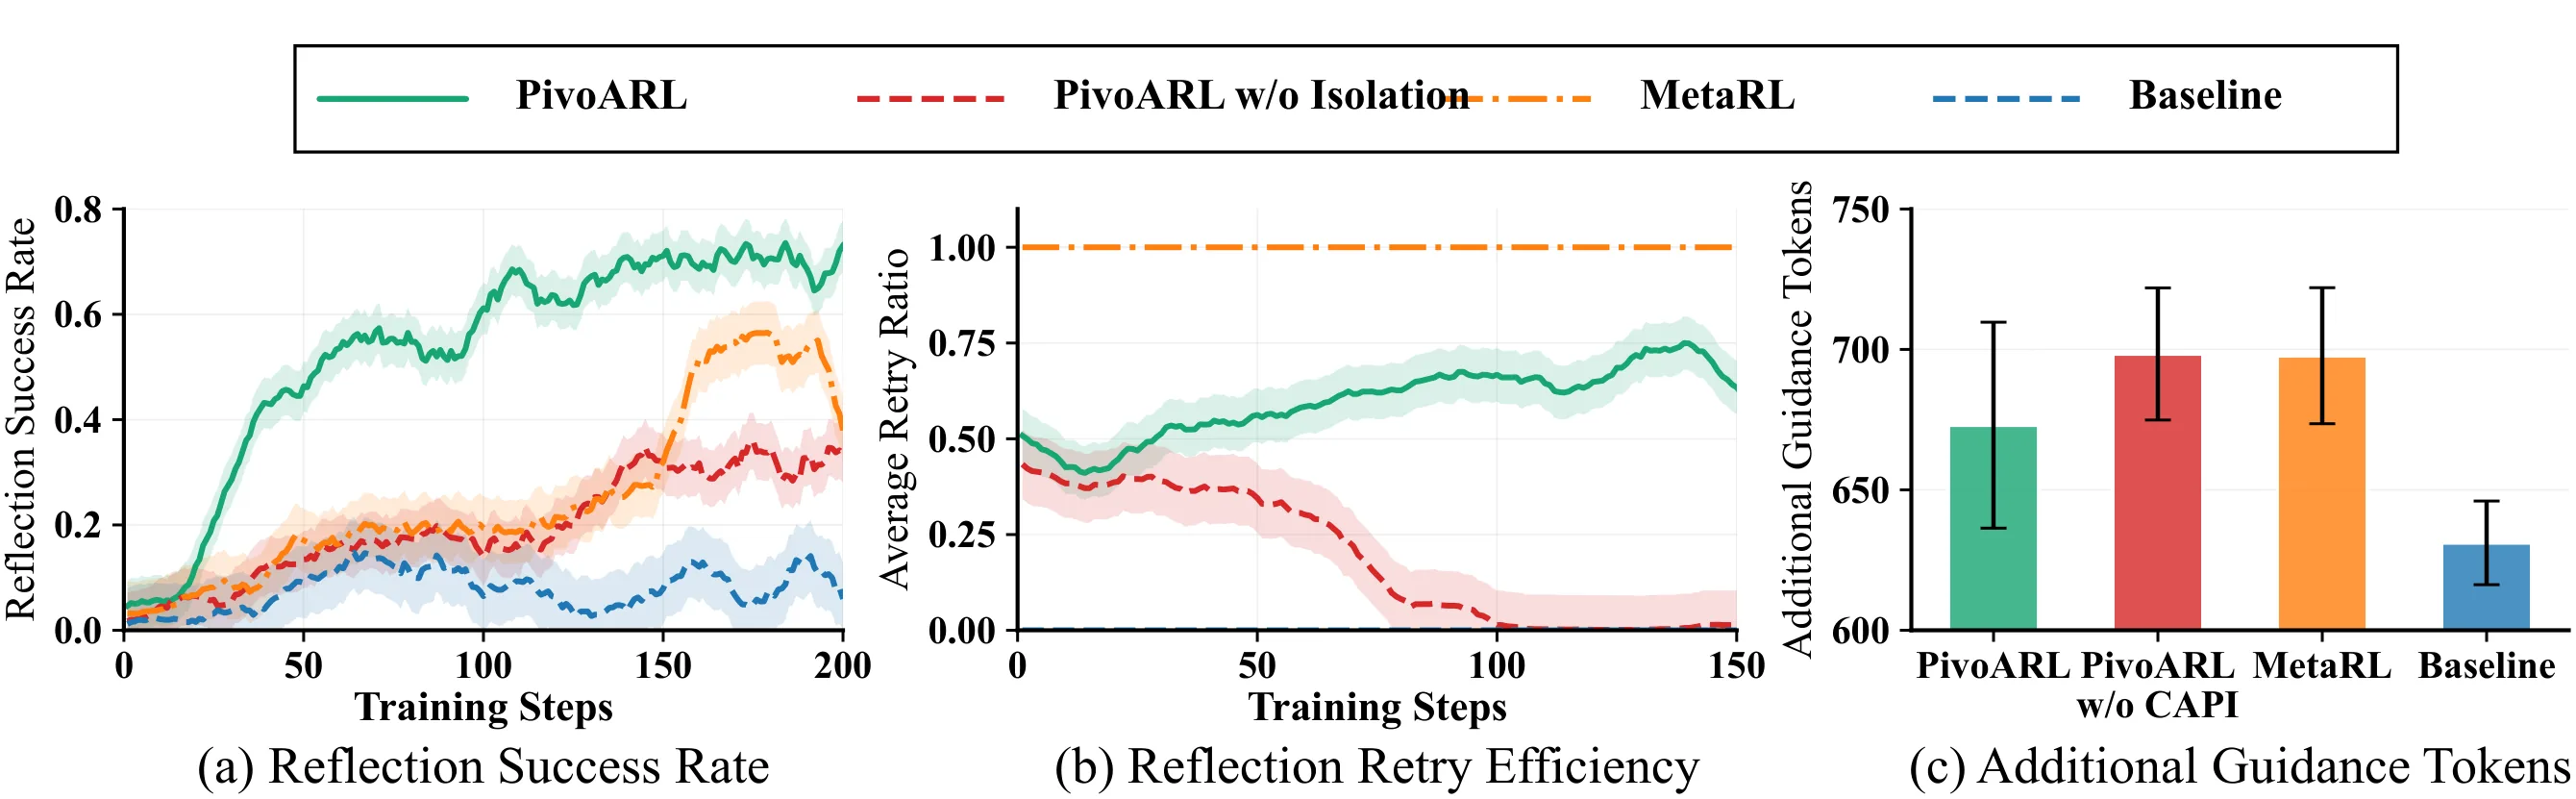
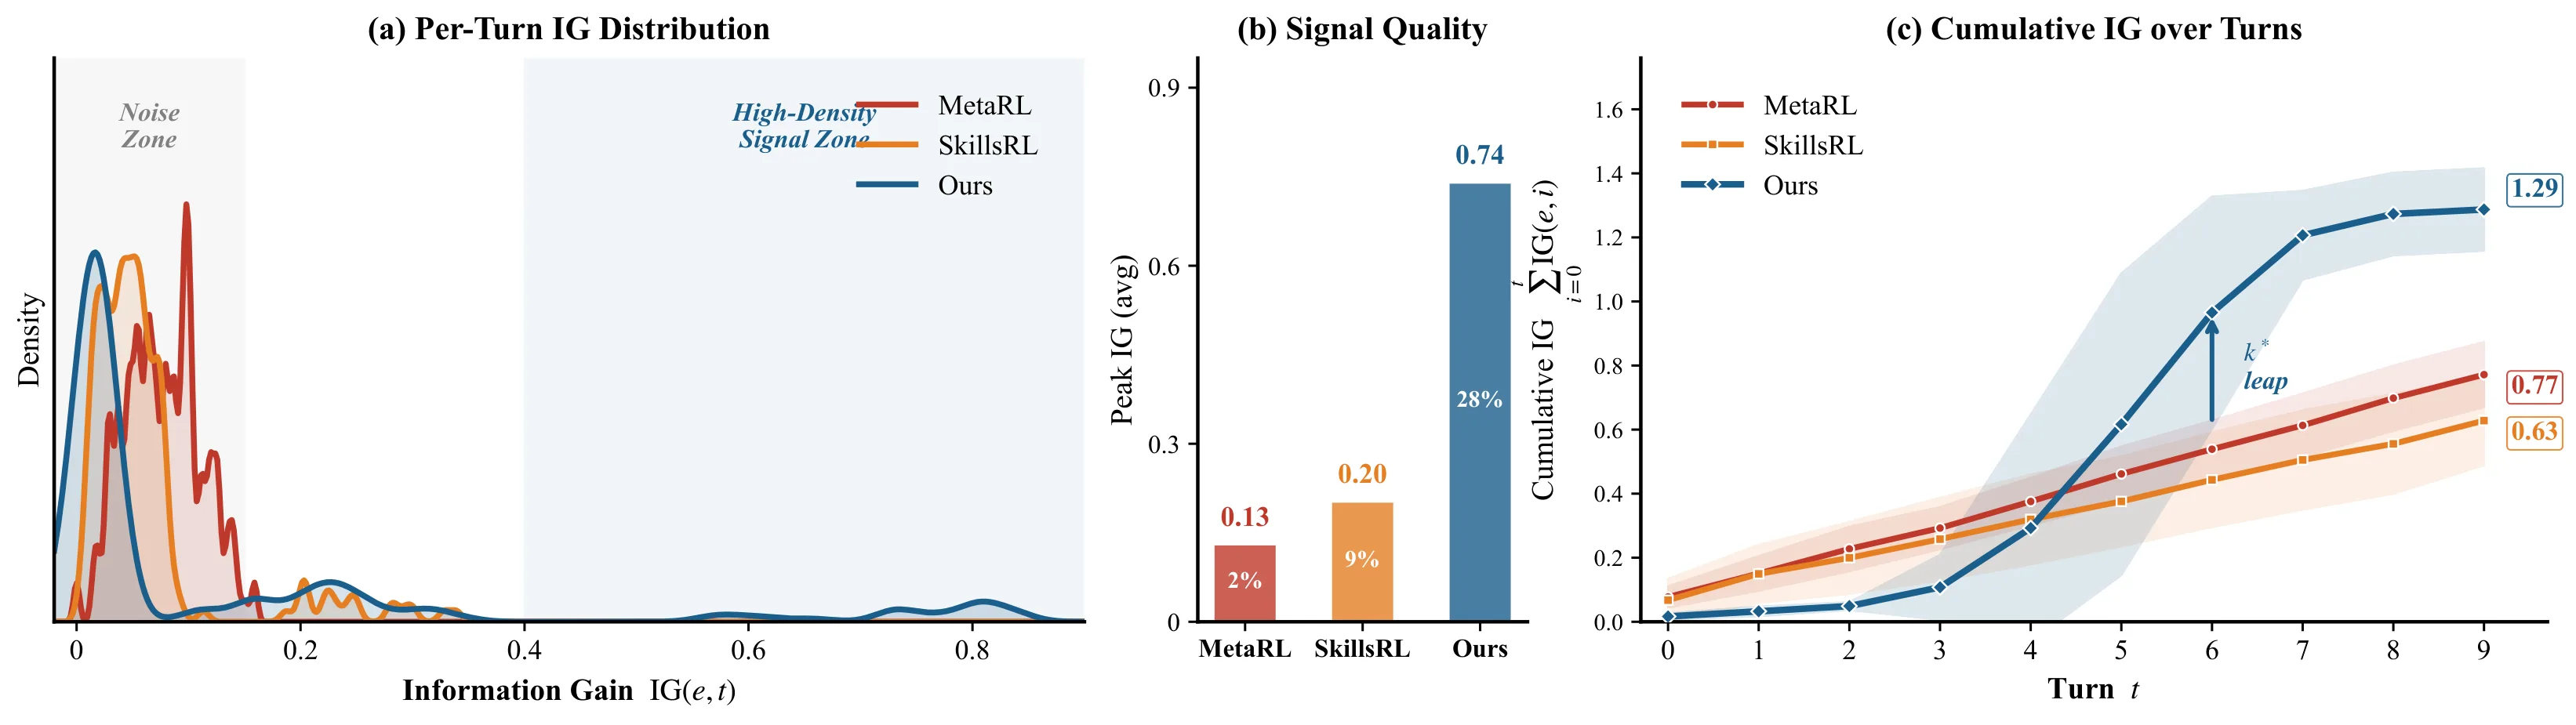
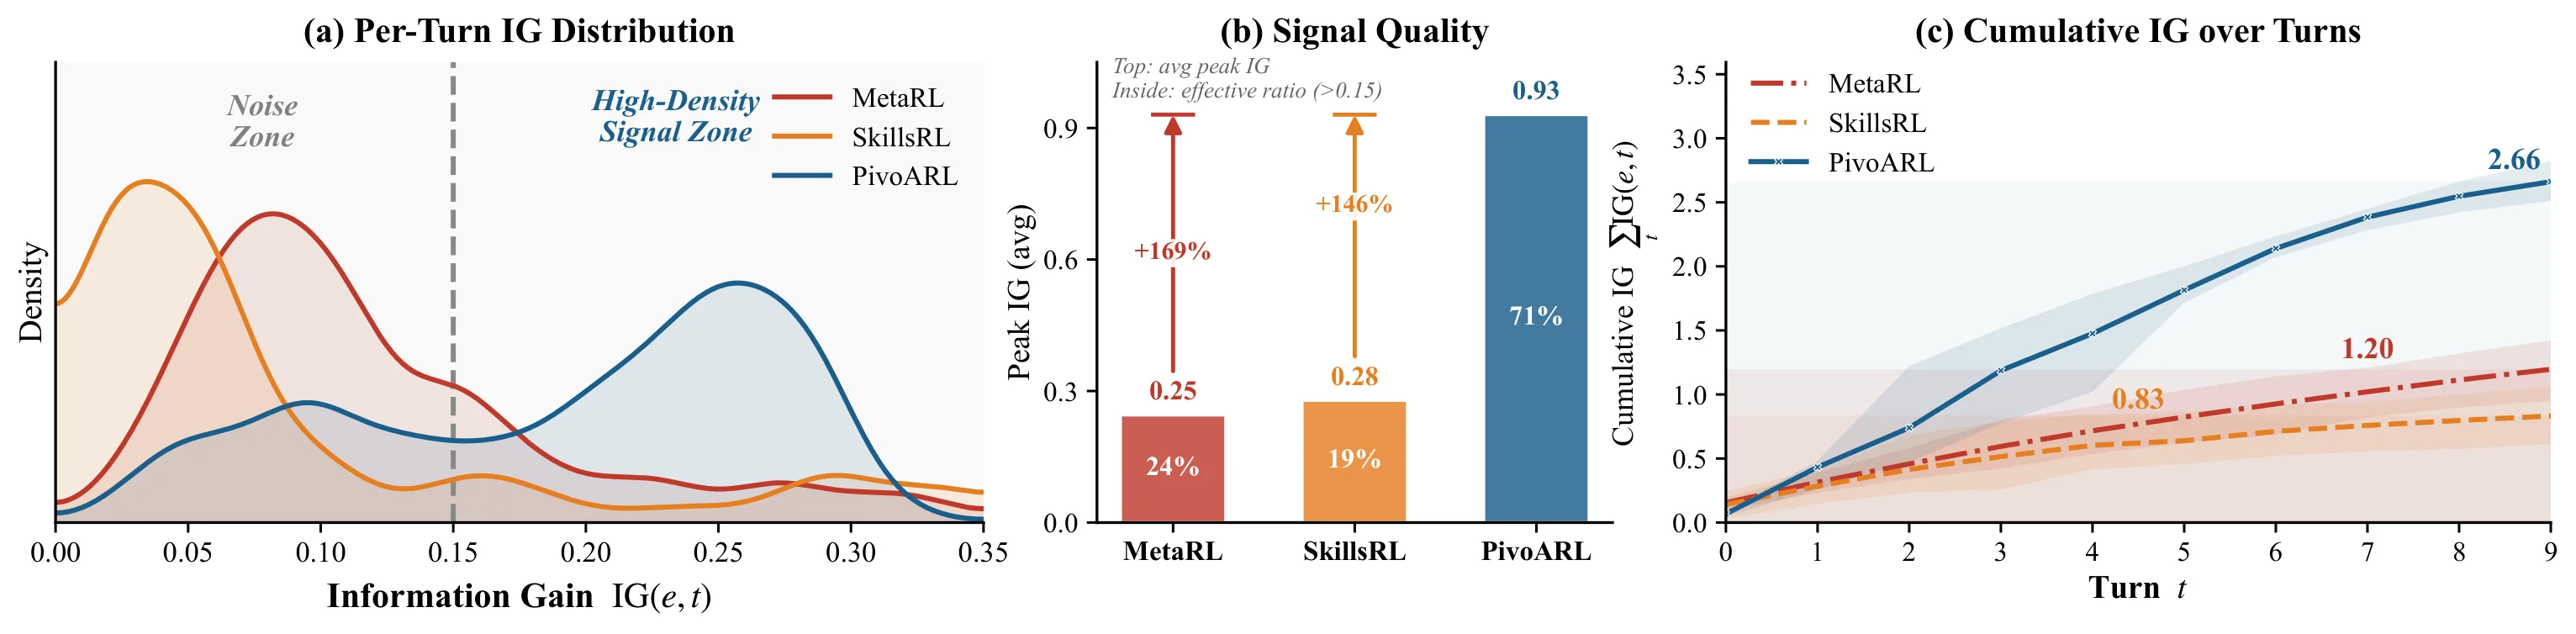
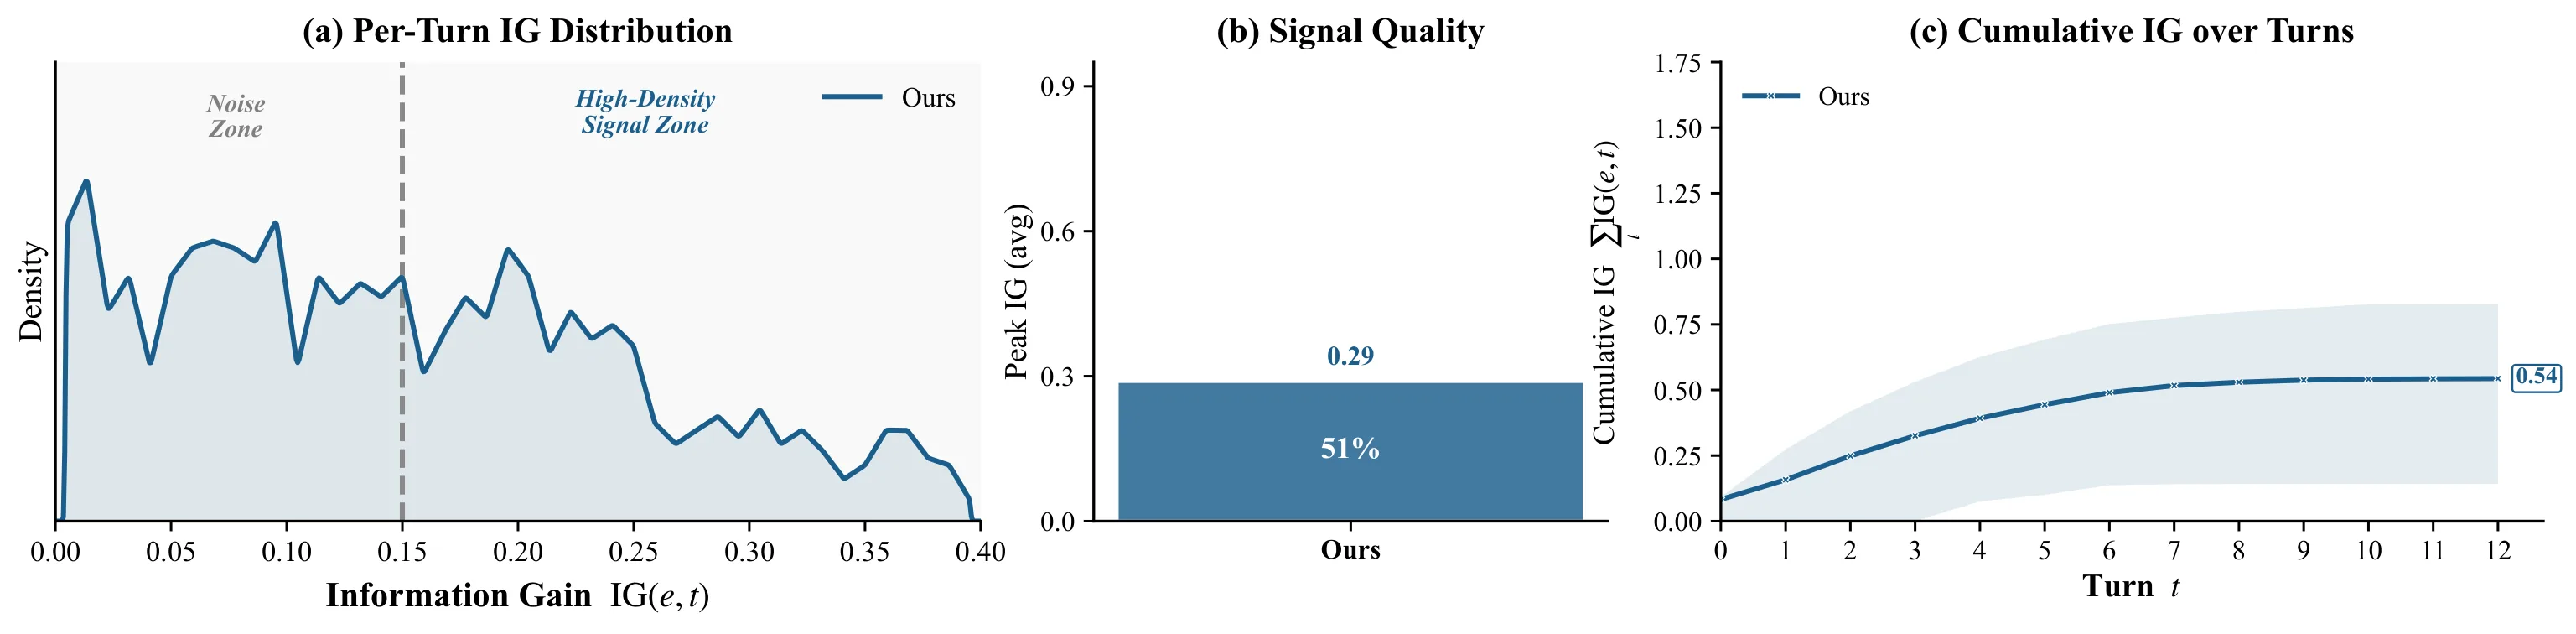
第三阶段是关键步骤感知的信用分配。当局部重试产生多条轨迹后,如何判断哪些决策是好的、哪些需要进一步改进?论文设计了一种特殊的信用分配机制:对于保留的正确前缀给予正向奖励,对于重试过程中产生的错误后缀则进行隔离。论文从信息增益的角度证明,这种机制能够将有效的经验信号集中在错误边界附近,而不会被那些与当前错误无关的决策所稀释。
此外,论文还引入了隐式反思回报来优化反思质量。具体而言,反思本身的质量也会影响关键回合定位的准确性,因此 PivoARL 将反思的优劣也纳入优化目标,通过让智能体学习什么样的反思能够更准确地定位问题,来持续改进整个框架的表现。
实验与结果
论文在两个维度上进行了系统性的评估:4 个智能体任务和 7 个搜索问答基准。智能体任务涵盖扫雷游戏、AlfWorld 等需要多步交互和规划的环境;搜索问答基准则包括需要智能体进行信息检索、工具调用和多步推理的场景。
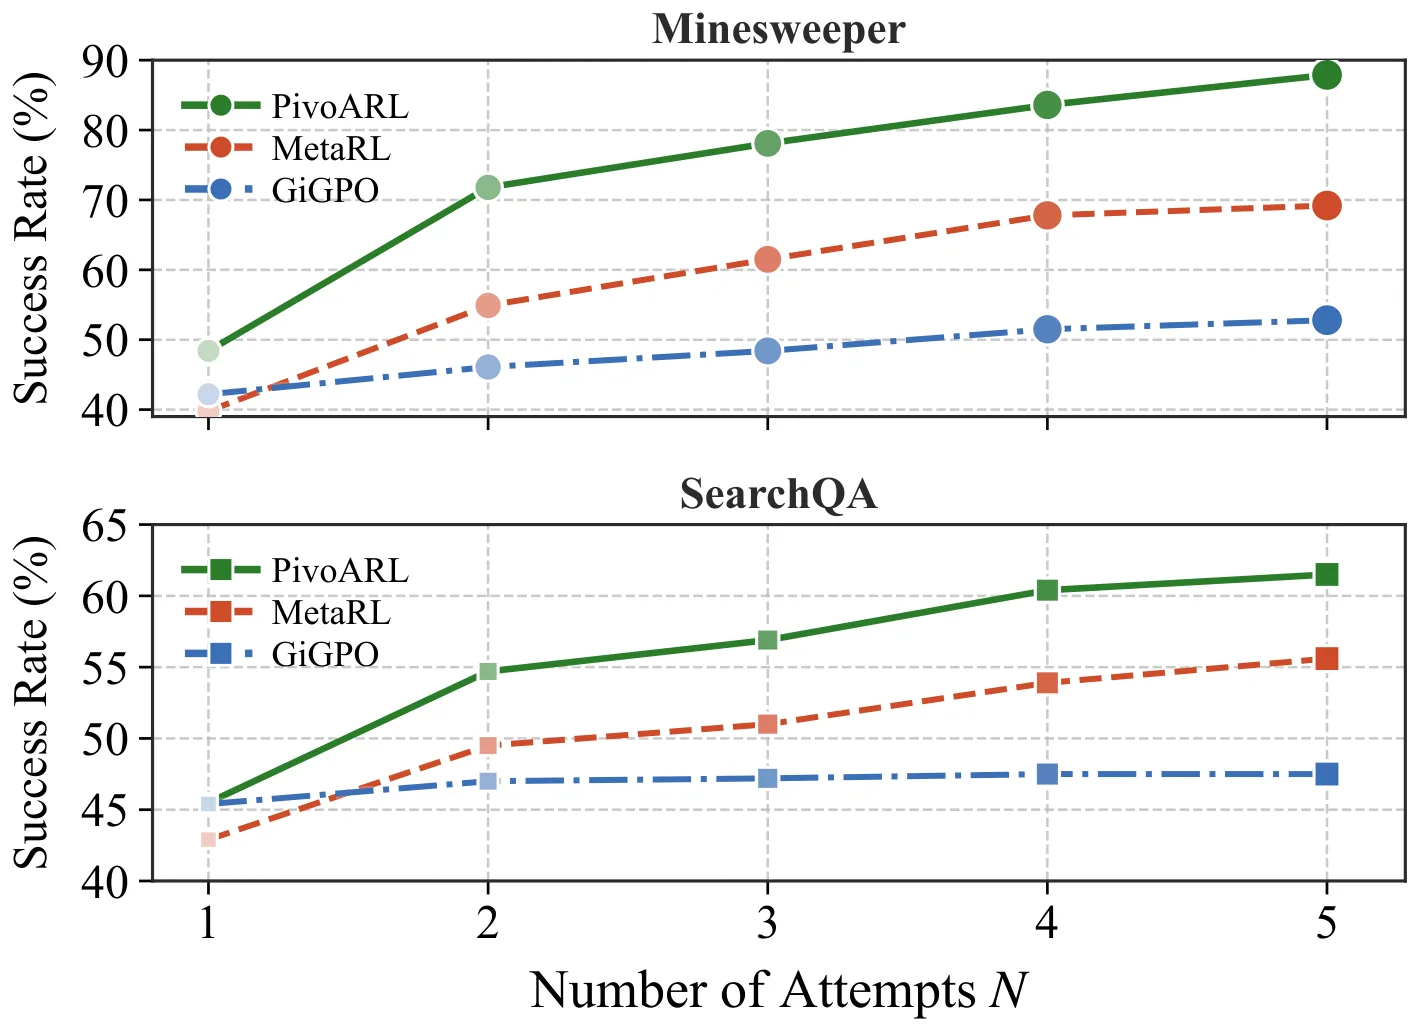
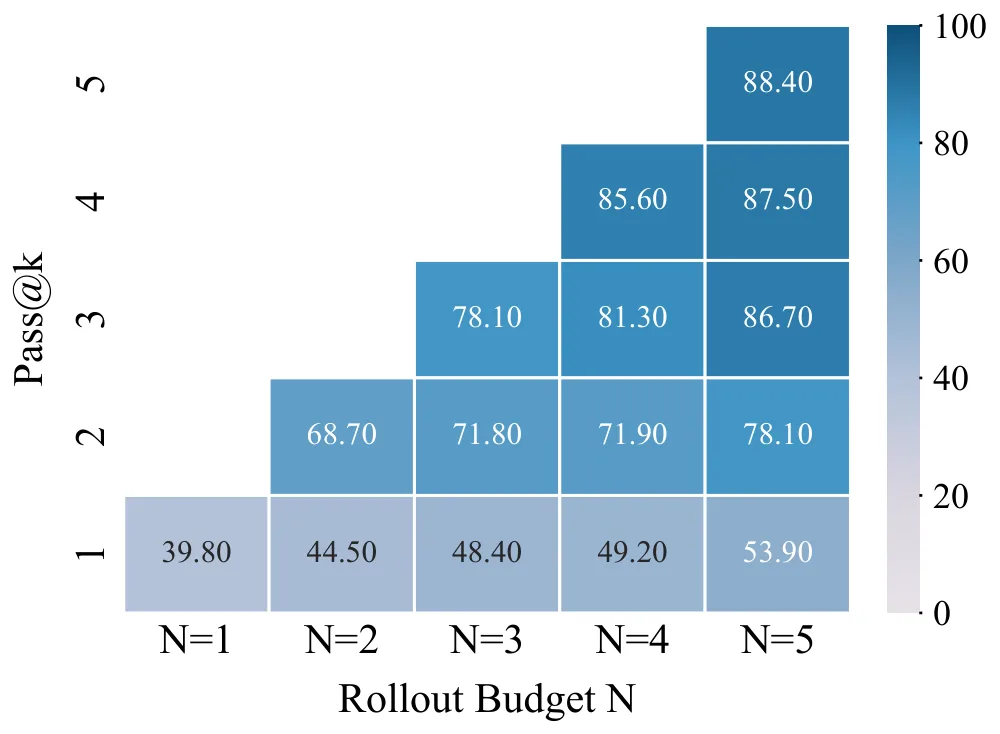
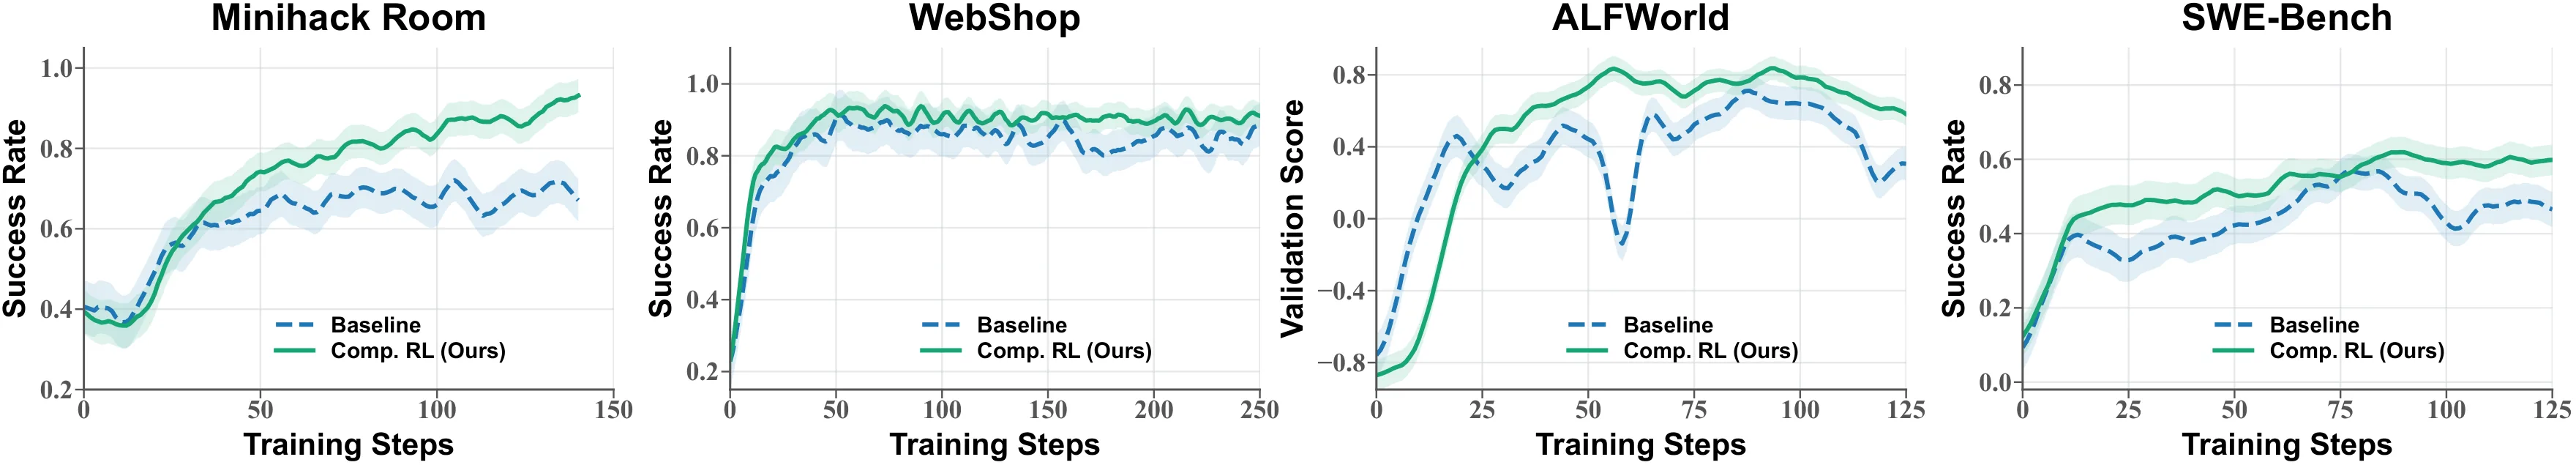
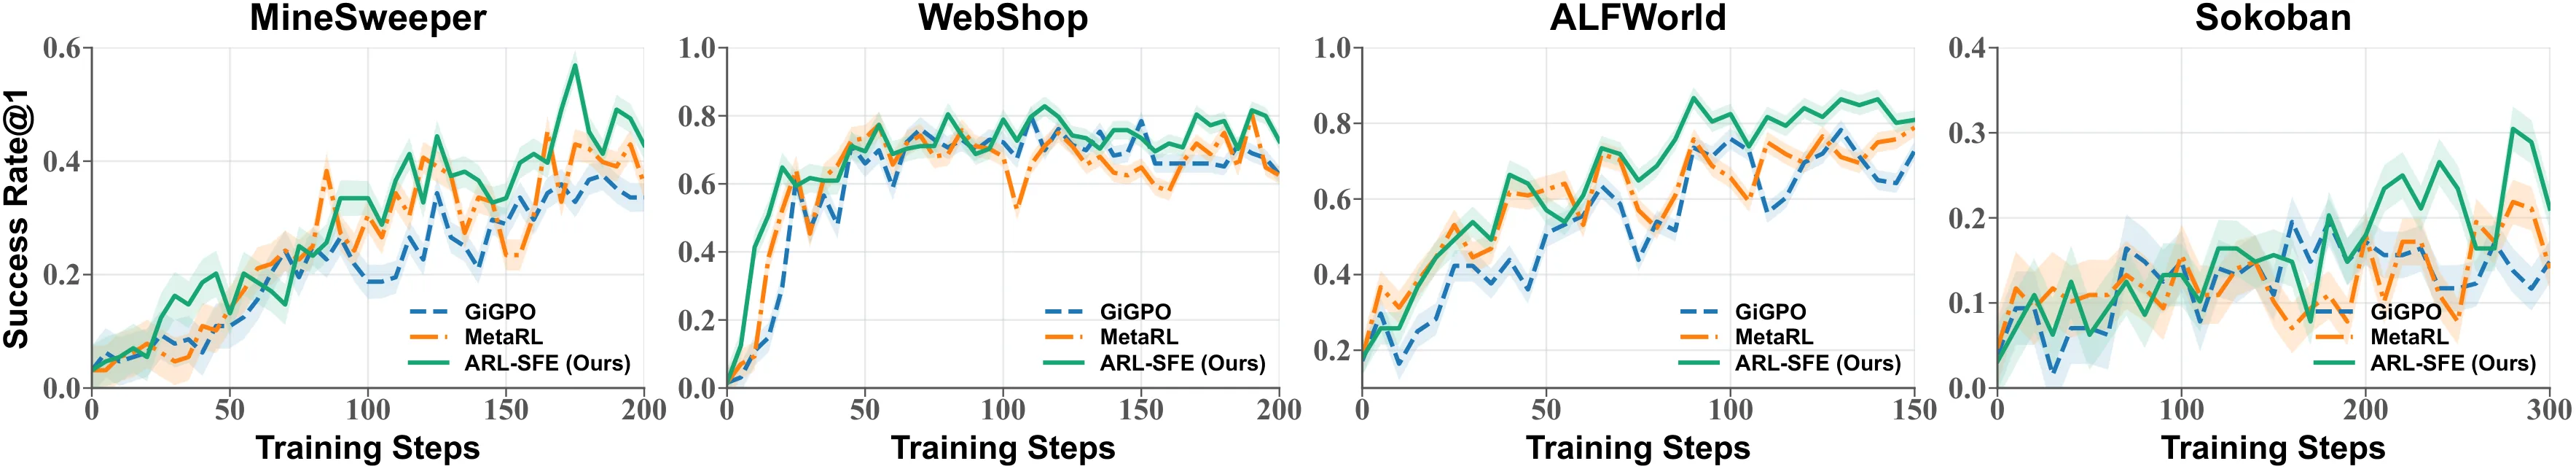
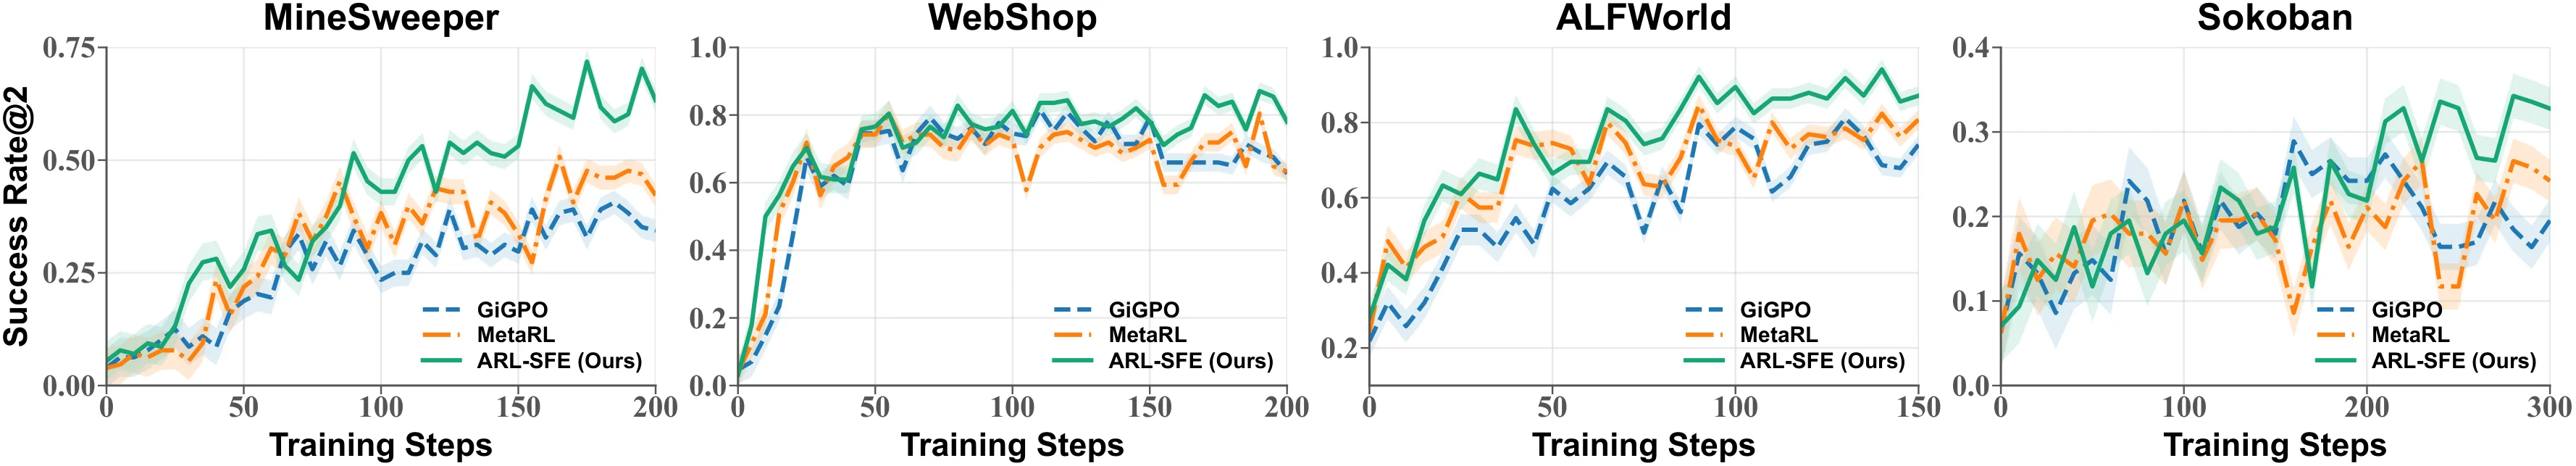
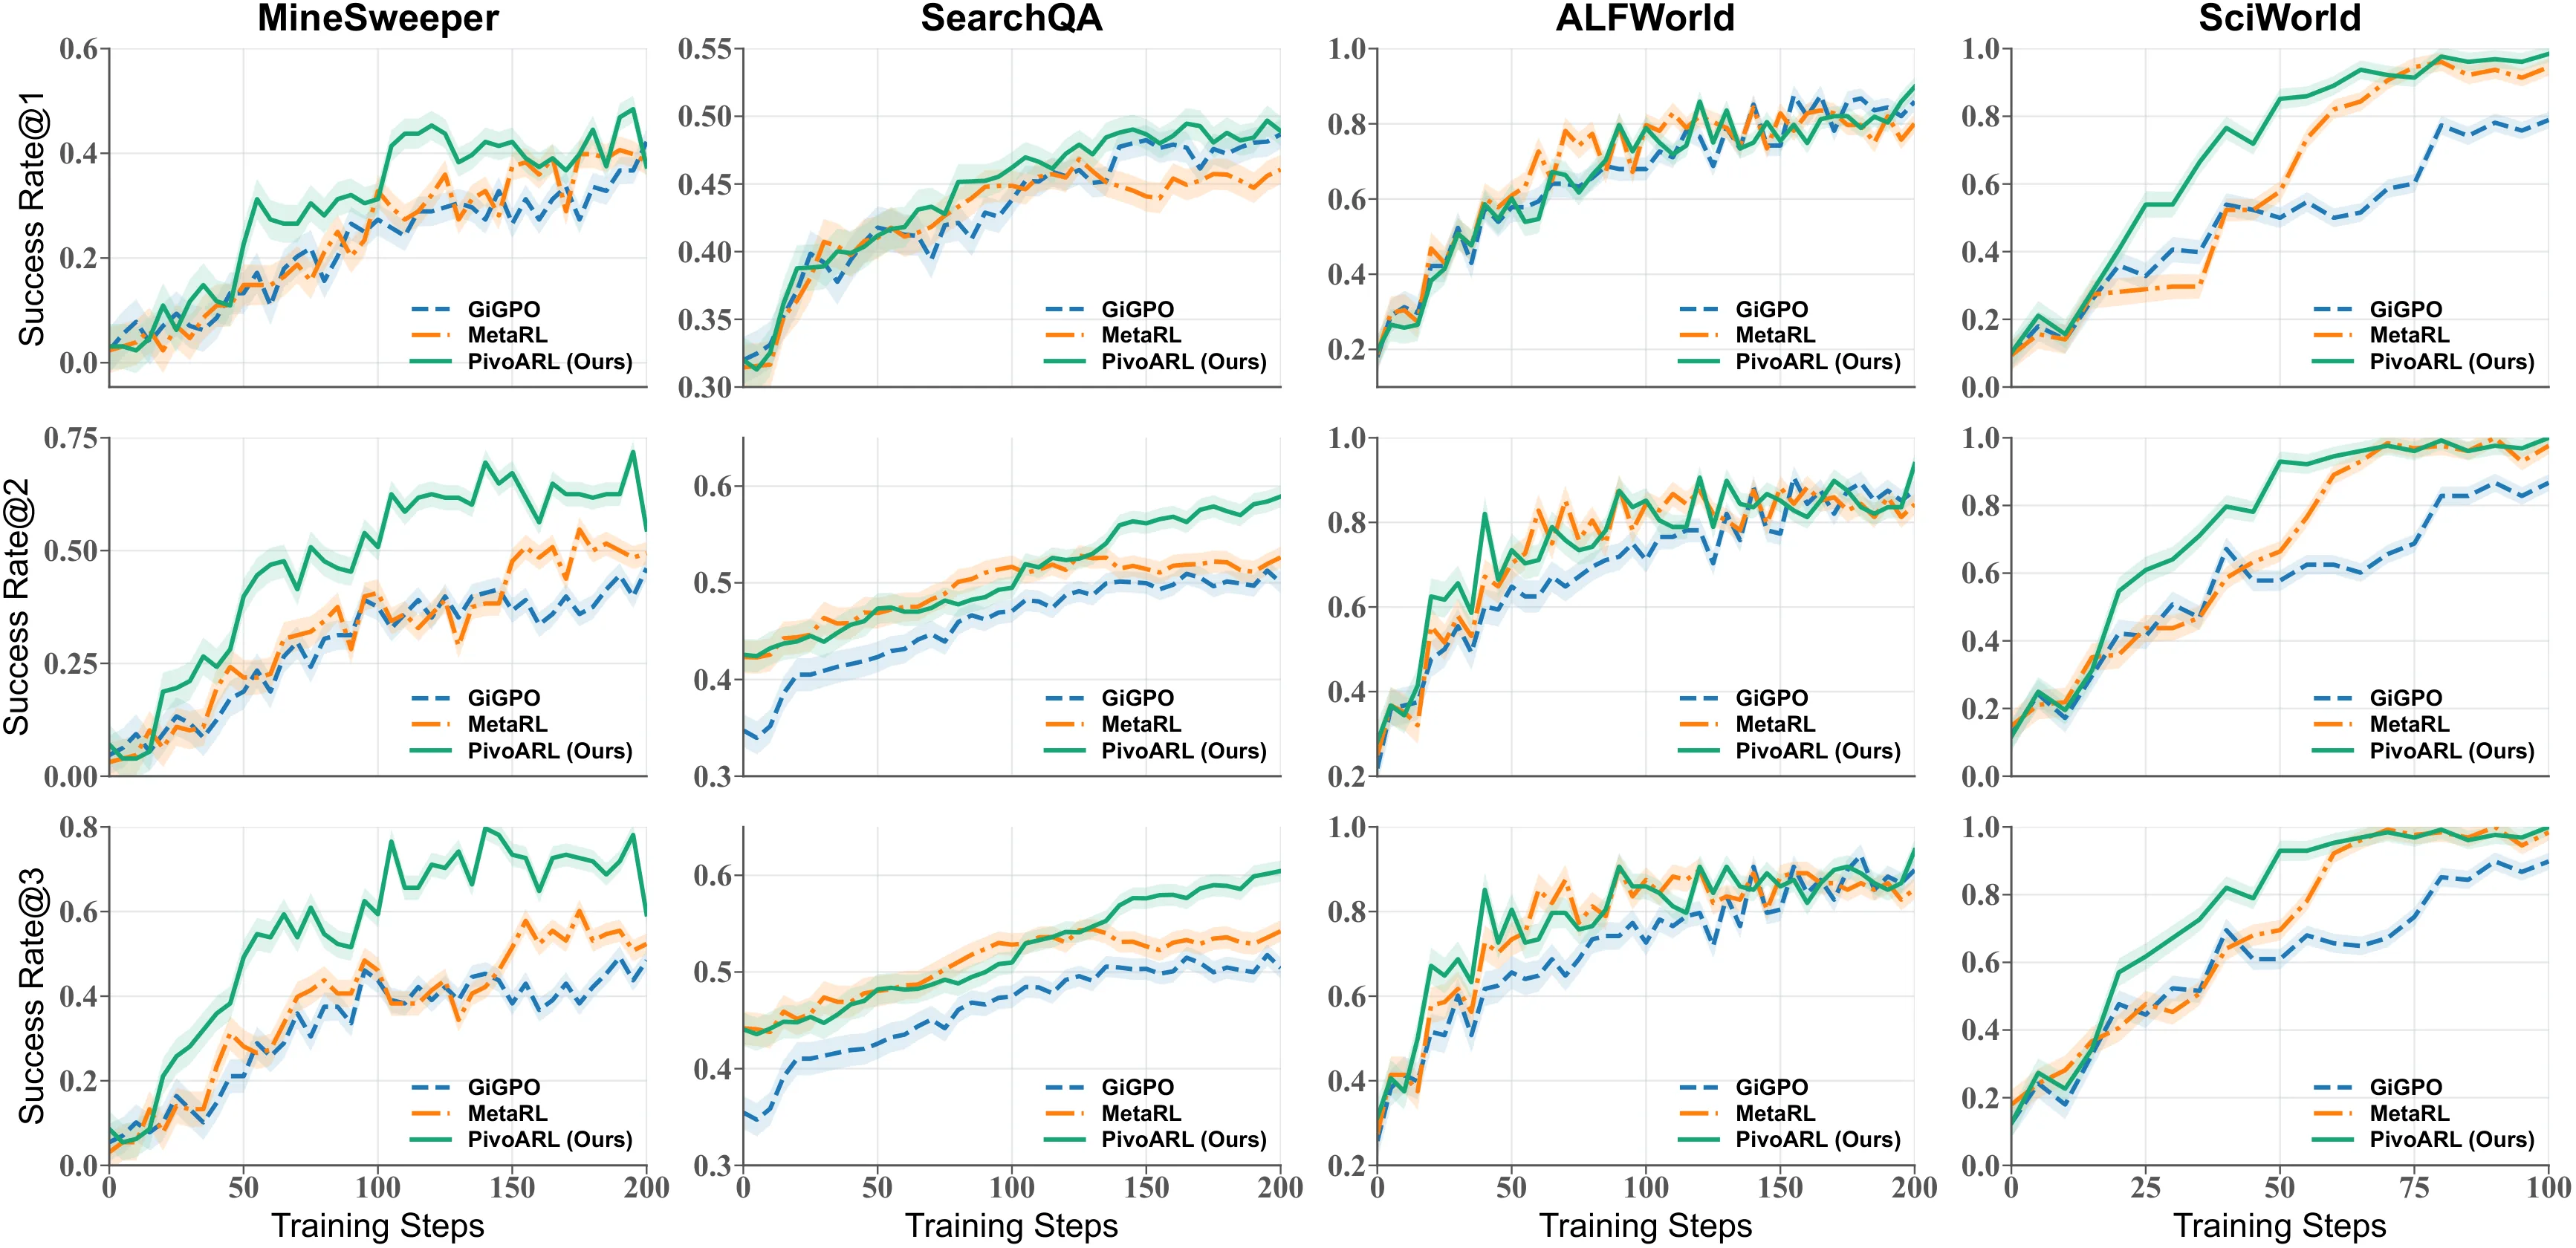
在 Pass@2 和 Pass@3 这类衡量多次尝试成功率的指标上,PivoARL 在所有任务上都取得了显著提升,相较于 MetaRL 平均提升约 11.5%。值得注意的是,Pass@1 的结果同样值得关注:在超过 80% 的任务上,PivoARL 也持续改善了单次尝试的成功率。这意味着关键步骤感知的信用分配不仅帮助智能体在多次尝试中更好地复用正确经验,还使得首次决策的质量本身得到了提升。
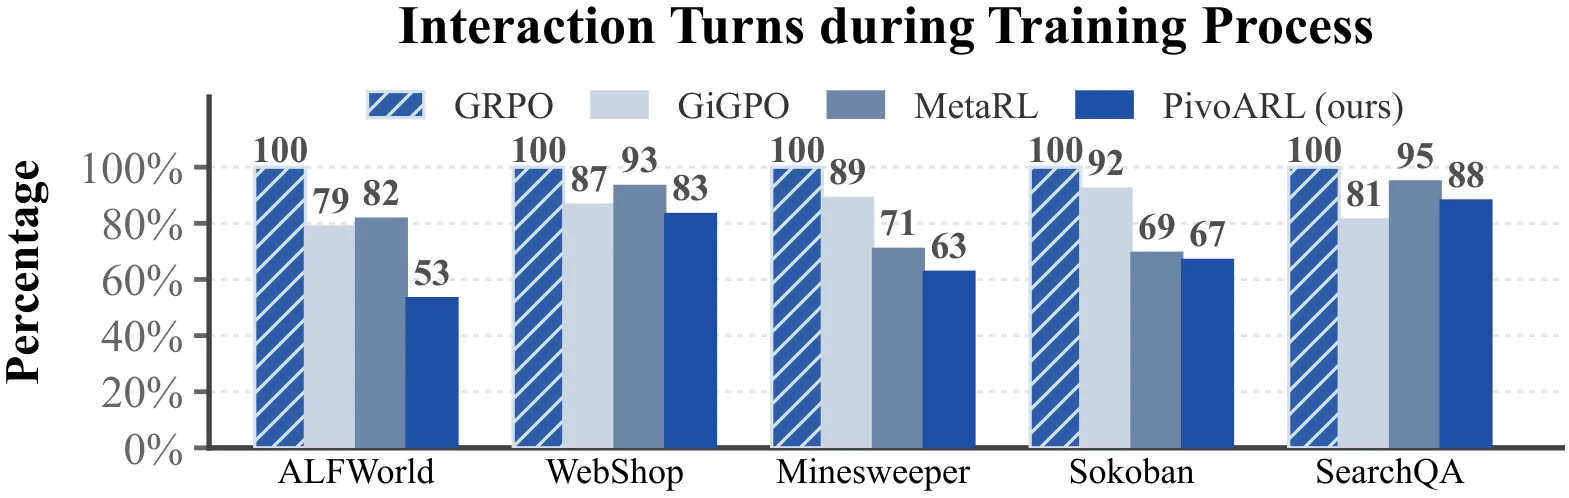
扫雷环境是一个特别有意思的实验场景。在这个需要精细规划和不确定性决策的任务中,PivoARL 相比 GiGPO 提升了超过 45%,这在其他基线方法中是非常罕见的提升幅度。更关键的是,PivoARL 平均减少了约 42% 的交互轮次,表明局部重试策略确实有效地避免了冗余的环境交互。
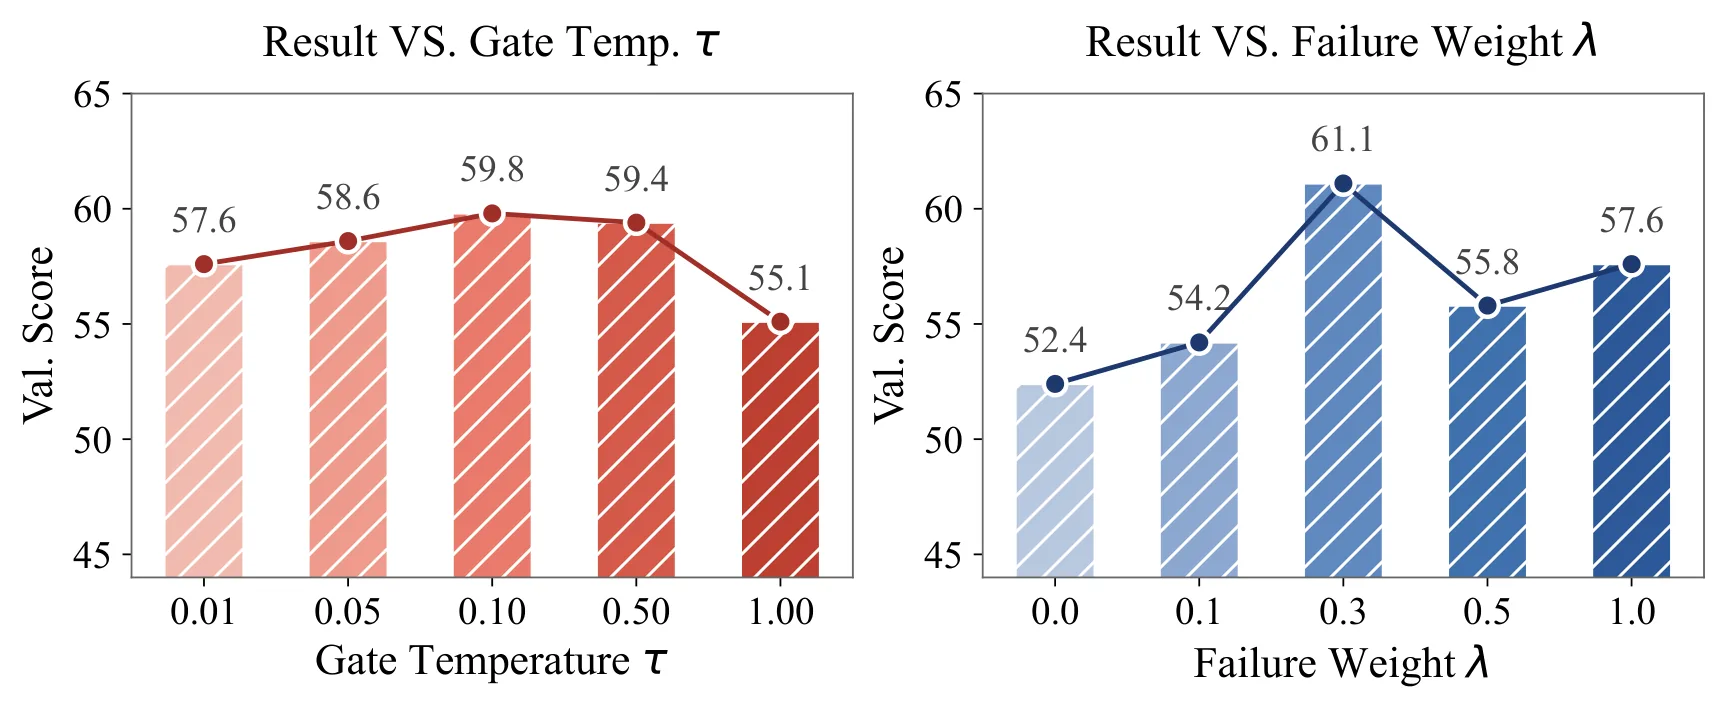
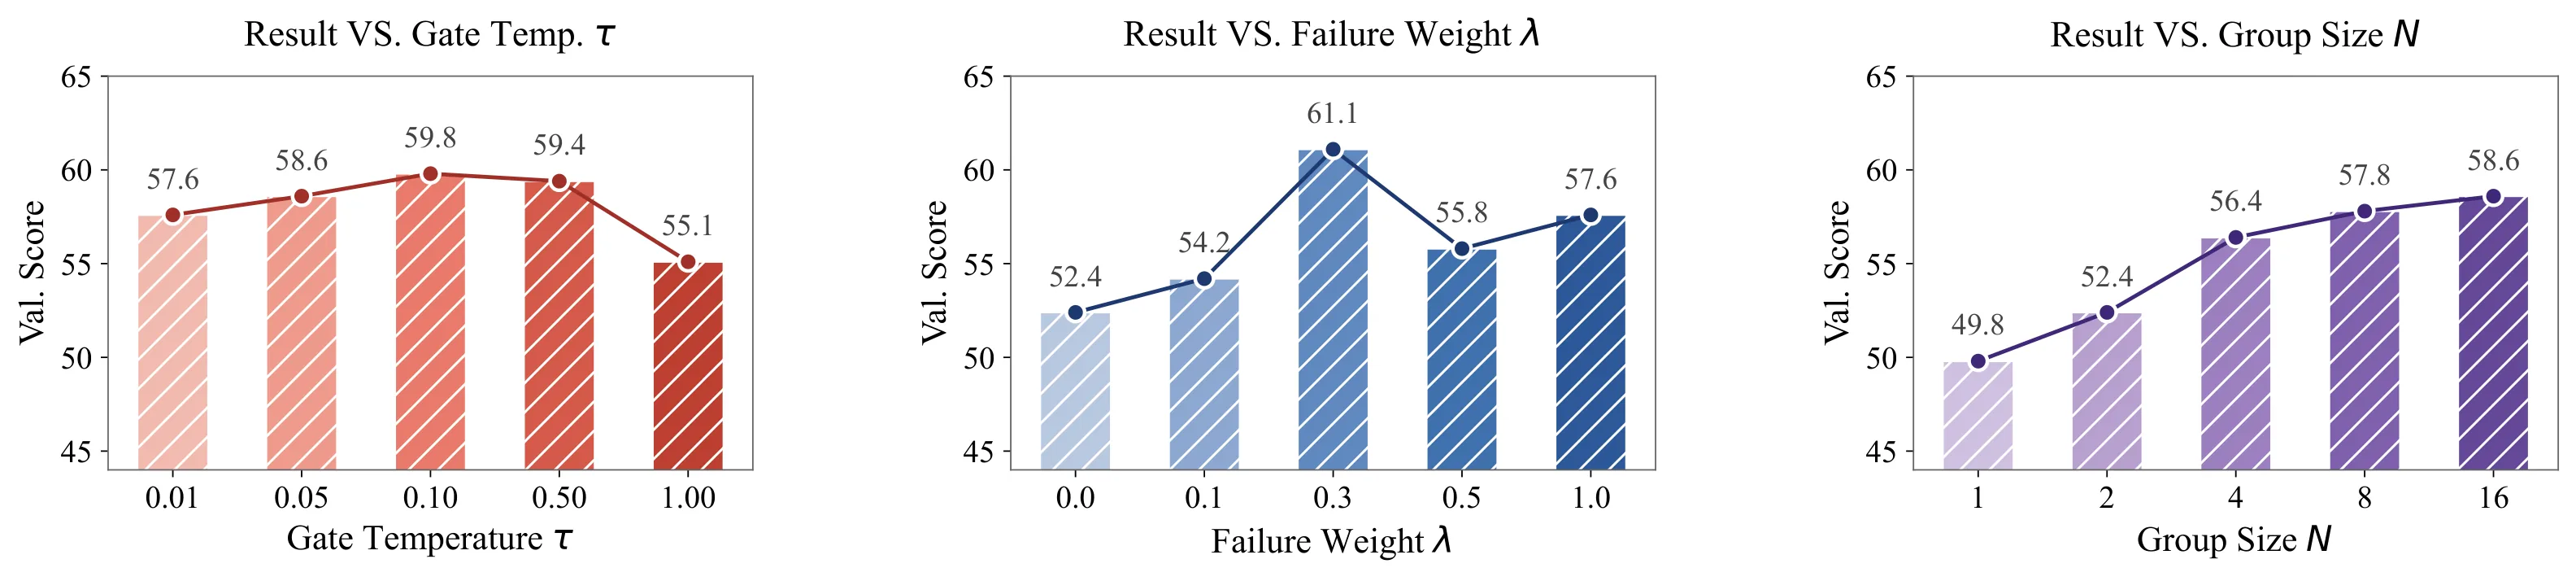
论文还进行了消融实验,验证了各组件的贡献。结构化反思相比非结构化的简单反思,能够更准确地定位关键回合;关键步骤感知的信用分配相比均匀分配信号,效果显著更好;隐式反思回报的引入则进一步提升了反思质量的稳定性。
讨论与可借鉴点
PivoARL 的一个重要贡献在于理论层面的分析。论文从信息增益的角度证明了关键重试的价值:当我们只针对错误边界附近的状态进行重试时,有限的经验信号被集中在最有可能产生改进的方向上,而不是被分散到整个状态空间。这为「局部重试」这一直觉性的策略提供了严格的理论解释。
然而,论文也存在一些局限性。首先,关键回合的定位依赖于反思的质量,如果反思不够准确,可能会错误地选择一个非关键的状态作为重试起点,反而降低效率。其次,论文假设存在「正确前缀」和「错误后缀」的清晰分界,这在一些边界模糊的任务中可能不成立。此外,反思过程的额外计算开销也是实际部署时需要考虑的因素。
对于该领域的研究者而言,PivoARL 的思路提供了几个值得借鉴的方向。其一是将「关键步骤识别」引入 [[LLM智能体]] 的学习框架,这是一个此前较少被系统研究的课题。其二是 [[信用分配机制]] 在长程任务中的应用方式——论文展示了一种不依赖梯度、仅通过结构化信号实现精准信用分配的可能性。其三是对反思过程本身的优化,这种「学会反思」的思路或许可以推广到其他需要元认知能力的场景。
摘要
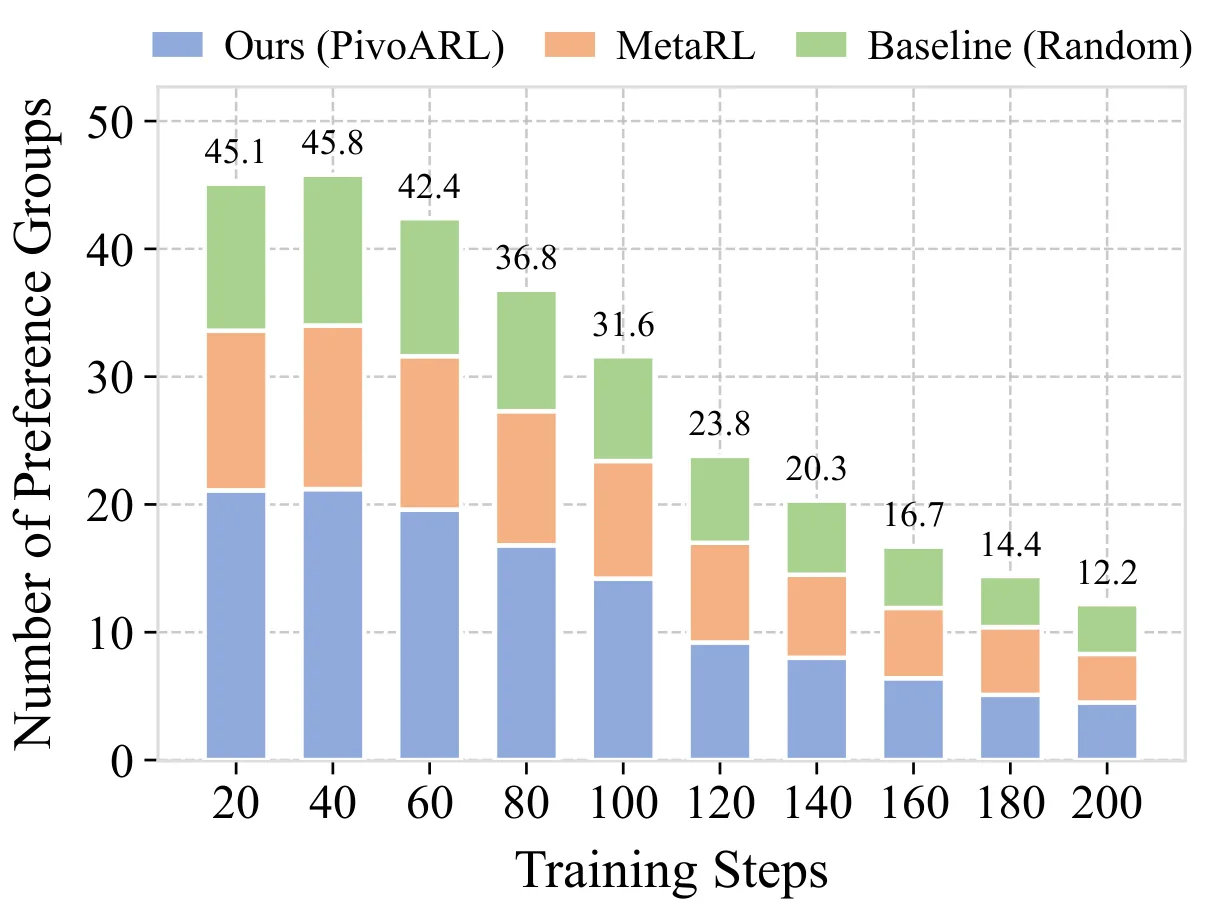
大语言模型(LLM)智能体在长时序交互任务中展现出了强大的决策能力,但它们仍然难以有效利用失败的轨迹:完全重试会产生高昂的交互成本,而经验检索往往会稀释关键的经验信号。为解决这一问题,我们提出了 PivoARL,一种用于 LLM 智能体经验利用的自反馈重试框架。PivoARL 通过结构化反思识别关键的错误回合,并仅从相应的关键状态进行局部重试,从而复用正确的轨迹前缀并减少冗余交互。从信息增益的角度,我们进一步证明关键重试能够将有效的经验信号集中在错误边界附近,缓解由与状态无关的经验利用所造成的信号稀释问题。基于这一洞察,我们设计了一种关键步骤感知的信用分配机制,在奖励正确前缀的同时隔离错误后缀,并通过隐式反思回报来优化反思质量。我们在 4 个智能体任务和 7 个基于搜索的问答基准上进行了系统性评估。结果表明,PivoARL 在所有任务上的 Pass@2/3 均取得了显著提升,相较于 MetaRL 平均提升约 11.5\%。此外,得益于由关键回合所诱导的对比偏好信号,PivoARL 在超过 80\% 的任务上也持续改善了 Pass@1。在扫雷环境中,PivoARL 相较于 GiGPO 提升超过 45\%,并且相较于完全重试方法平均减少了约 42\% 的交互回合数。代码已开源,地址为 https://github.com/yuki-younai/PivoARL。
Abstract
Large language model (LLM) agents have shown strong decision-making capabilities in long-horizon interactive tasks, yet they still struggle to effectively leverage failed trajectories: full retries incur high interaction costs, while experience retrieval tends to dilute critical experience signals. To address this, we propose PivoARL, a self-feedback retry framework for experience exploitation in LLM agents. PivoARL identifies the pivotal erroneous turn through structured reflection and performs local retry only from the corresponding pivotal state, thereby reusing the correct prefix and reducing redundant interactions. From an information-gain perspective, we further show that pivotal retry concentrates useful experience signals near the error boundary, mitigating the signal dilution caused by state-agnostic experience utilization. Based on this insight, we design a pivotal-aware credit assignment mechanism that rewards correct prefixes while isolating erroneous suffixes, and optimize reflection quality through implicit reflection returns. We conduct a systematic evaluation on 4 agent tasks and 7 search-based QA benchmarks. Results show that PivoARL achieves significant improvements on Pass@2/3 across all tasks, with an average gain of about 11.5\% over MetaRL. Moreover, benefiting from contrastive preference signals induced by pivotal turns, PivoARL also consistently improves Pass@1 on over 80\% of the tasks. On Minesweeper environment, PivoARL improves over GiGPO by more than 45\% and reduces interaction turns by about 42\% on average compared with full-retry methods. Code is available at https://github.com/yuki-younai/PivoARL.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。